依旧瞎逼逼
这一代 GLM 5.3 Flash(前期以Ox-alpha在模型平台上进行测试,被网友们戏称为牛来模型,下文牛来即指本模型) 是小参数多模态大模型,啊这个这个前不久有一个朋友用着他的 DeepSeek V4 Flash 带着另外一个朋友一起写代码。他以为唉我去我们一起写,所以我写一路到完成,卧槽,然后他看了以后就震住了,说说这么好的模型怎么咋不早点告诉我。以前就跟你说了智谱这个模型5.3 Flash这个智谱这个智谱的技术很好,啊这个这个多模态很好用,他说我不知道多模态是意味着什么,他说你要早点告诉我,这就送了一个程序员
注:由于部分社区声音反馈 coding plan 降智严重,因此使用官方正价 api,但由于大模型本质黑盒,我无法确定在测试过程中是否被路由到量化版,测试结果仅供参考,不代表任何模型顶尖水平。
温馨提示:当前完全不建议使用GLM 5.3 Flash 进行长程任务或无人值守任务,很多人反馈犯蠢、误删文件,本次测试中均未进行实际长程任务测试,但在上下文体感上确实非常烂(详见文字创作部分)
实测
后端
依旧是祖传测试集
h10,不算难,快速过一下结果
GLM 5.3 Flash
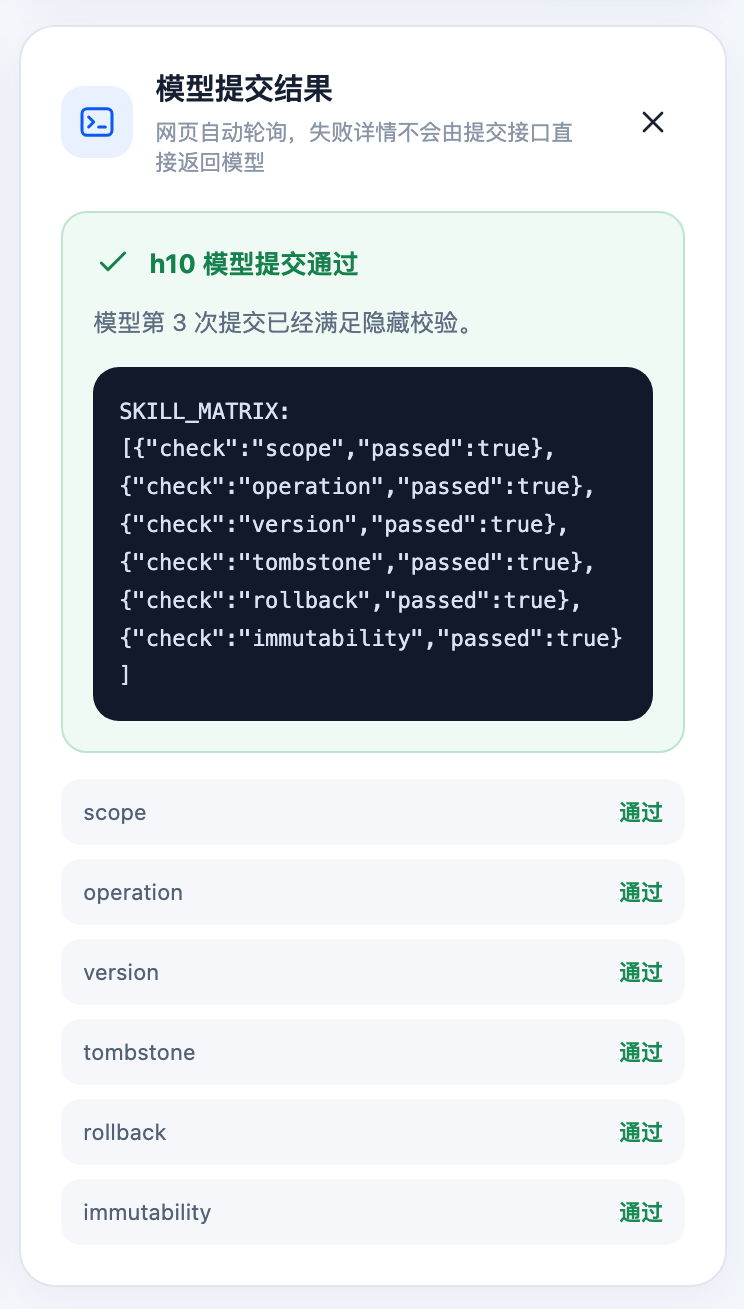
3次,但这里要说明一下:其中有次是他自己提交测试的,那一次就是全绿,也就是说应该算两次过
友商结果快速过一下:
测试若未说明环境,则均默认为该模型官方Harness(优先 macOS 客户端,优先级第二的是cli,最后是vscode插件),且清空用户约束或项目约束,并关闭全局记忆及类似可能作弊的功能。若未说明,默认思考额度为最高
- GPT 5.6 sol、GPT 5.5 (Extra High)、GLM 5.3、Kimi K3(Claude code测试,kimi code 太垃圾了):一次过
- GPT 5.6 Luna、GLM5.2、Claude Opus 5(随便找的中转站,自称为Max渠道):两次
- DeepSeek v4全系、GLM 5 Turbo、Claude Sonnet 5(同上)、Gemini 3.7 Flash:三次过
- Claude Haiku全系、Gemini Flash lite 全系、GPT 5.4及之前的GPT系模型:均未在 5 轮内完成测试
实话说,效果一般,绝对算不上顶尖水平,无论是国内还是国际上。
这一代模型很粗心,什么自己改坏原有逻辑、调用工具失败、写错命令都是常有的事——他首轮自己根本没有测试,导致他自己原有项目还在那里跑着就交付,规则里明确说明了要关闭本地开发进程再提交否则会失败,他不听。
前端
水墨风个人页:点我
解构主义个人页:点我
产品落地页:点我
水墨风和解构主义我个人认为是很不错的,特别是在多模态的加持下,它能够自己进行视觉测试,这对前端的帮助非常大!
当然,这里我只测试了最基础的单文件 html,更多的动效就没测了,感兴趣的可以自己试试
文笔
这个我必须说道说道,好多人都说比较差,但我用下来还不错,特别是各位的人之常情方面的写作/rp
国内模型:
海外模型(需特殊网络环境):
都说文笔差,我觉得还行。不过这一代好像在小说写作的时候容易丢上下文,导致部分设定丢失,且思考时间普遍较长,基本都奔 5 分钟去了
匿名测试时的记录
多模态能力
这个我也不知道怎么测 各位图一乐就好
任务 1:
GLM:https://chat.z.ai/s/ab572eee-35c6-4e1d-a050-60730e60aa52
Gemini:https://share.gemini.google/VZyW0Rlqr9LJ
省流:都错误的将发型识别为帽子
任务 2:
GLM:https://chat.z.ai/s/9280a403-bf39-444a-9f28-3cec4b09d520
Gemini:https://share.gemini.google/mjzNx8FjSOuJ
这一个任务有意思:Gemini Pro 和 Flash 均未能识别出阿狸形象,反而是参数量更小的GLM识别出来了,复现结果也很有意思,虽然 GPT image2 没有阿狸的训练资料,但是乍一看还是 GLM 的版本更加和谐
https://chatgpt.com/share/6a8fa86a-370c-83ea-be6f-492ccde7f999
任务三:像素级输出
GLM:
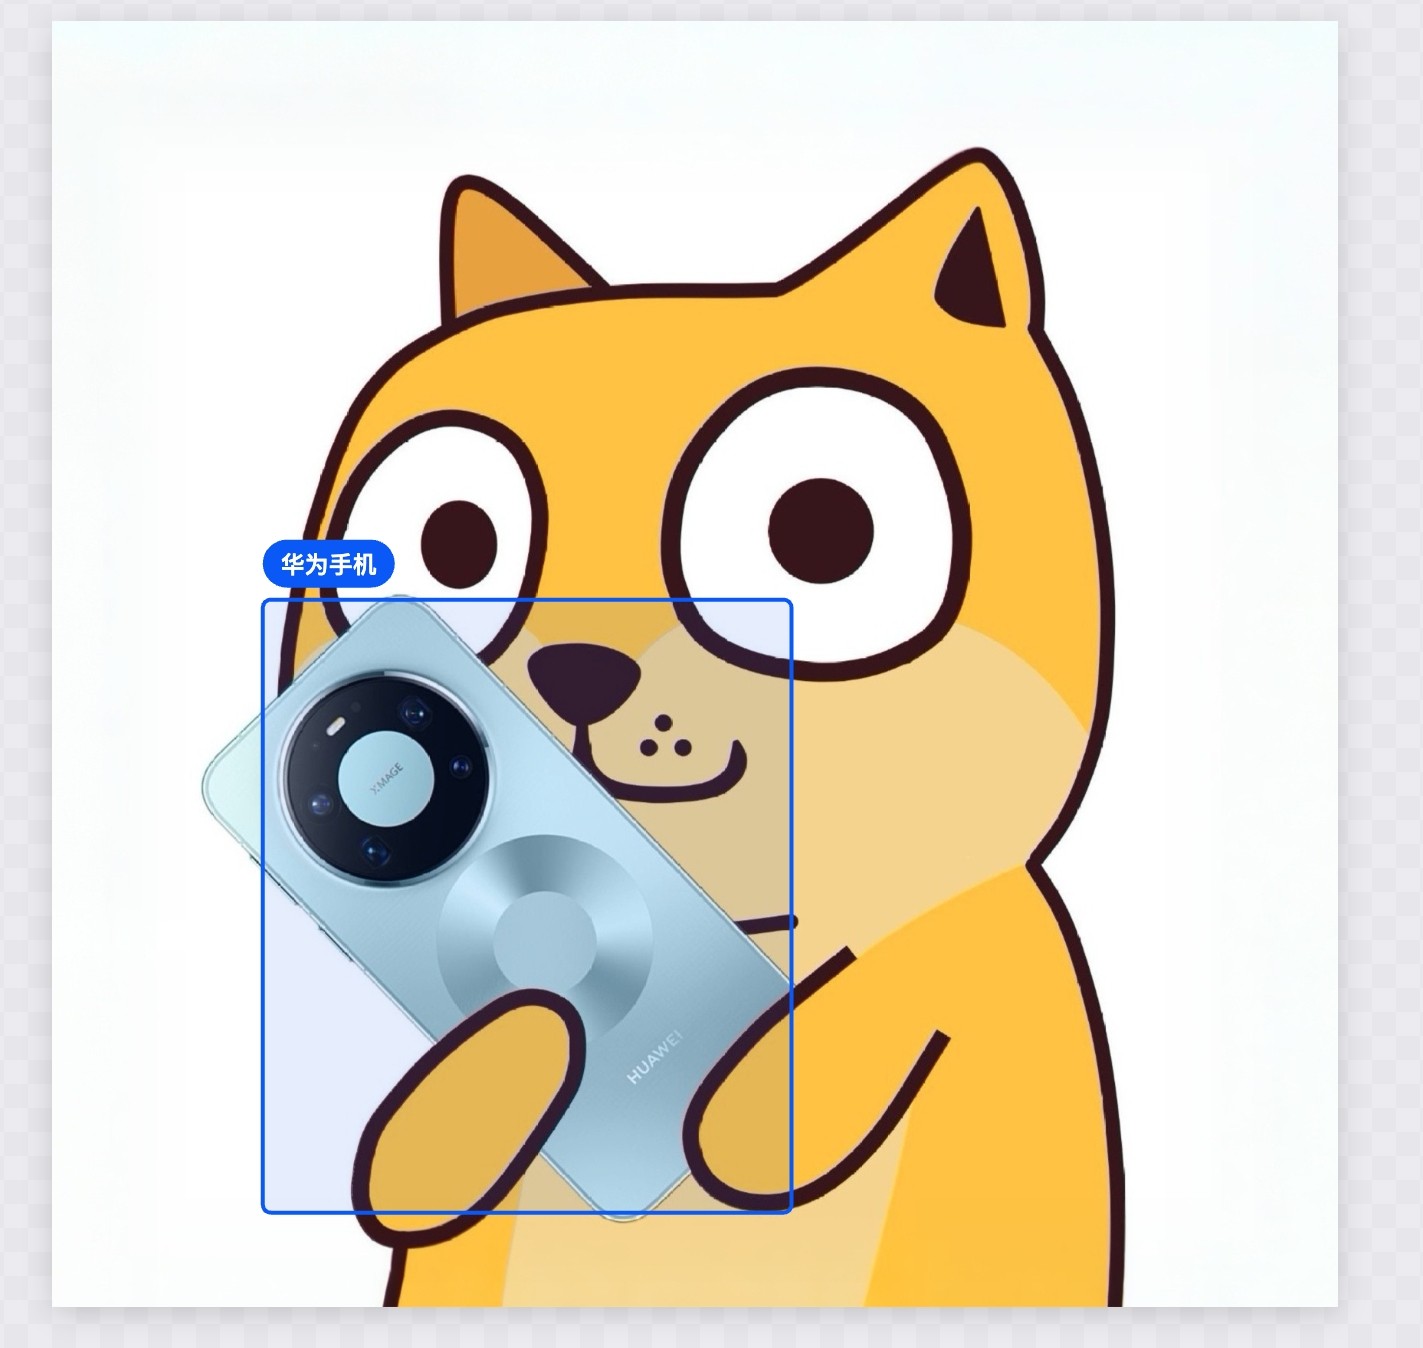
GPT: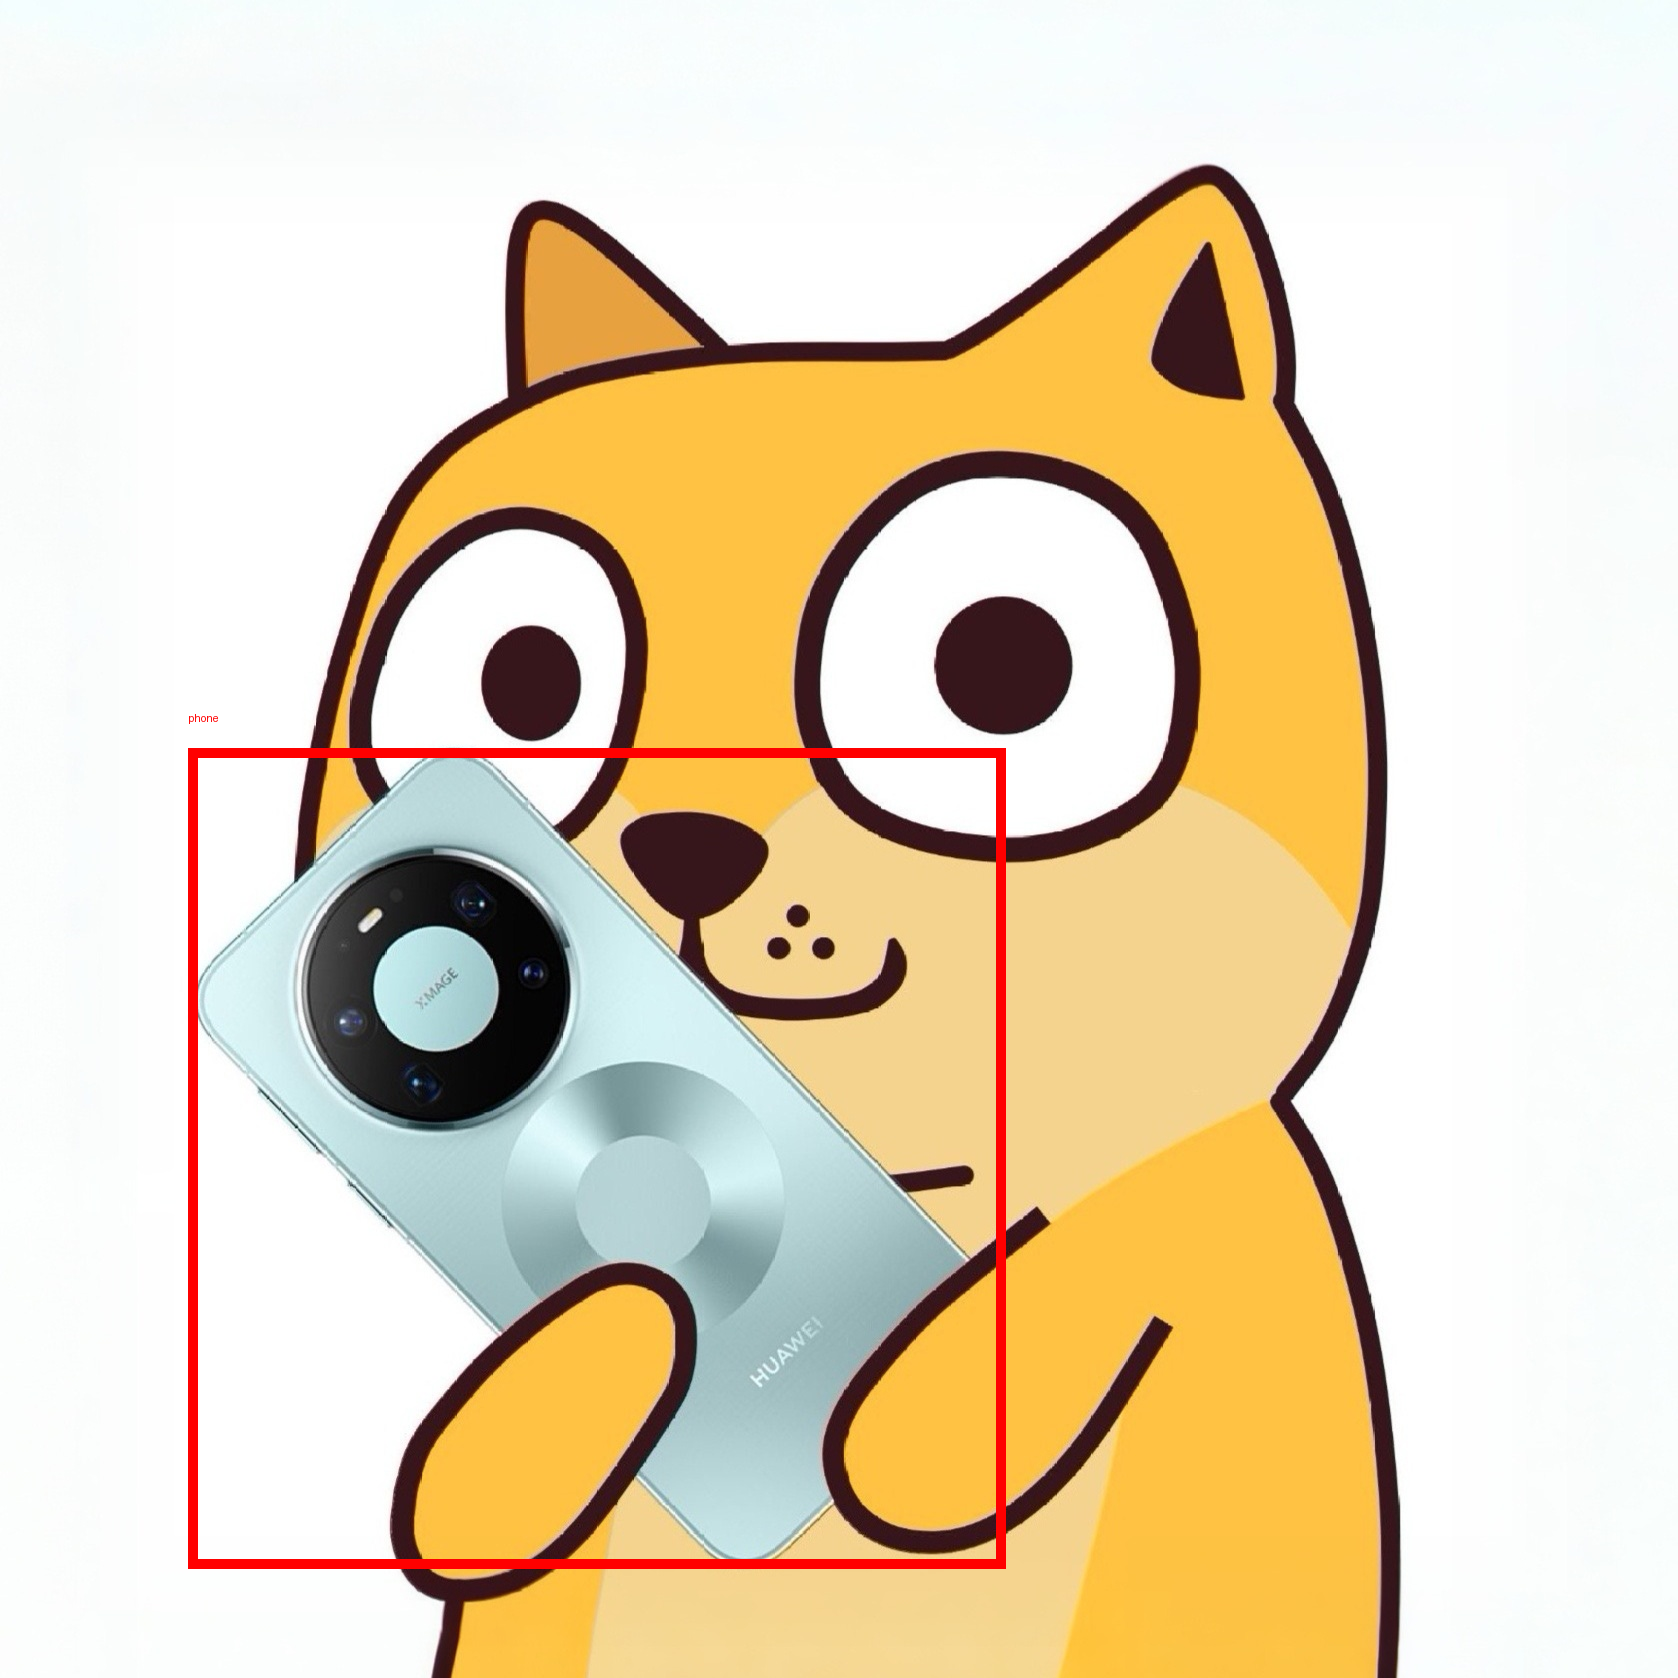
Gemini Pro/Flash 效果均差不多: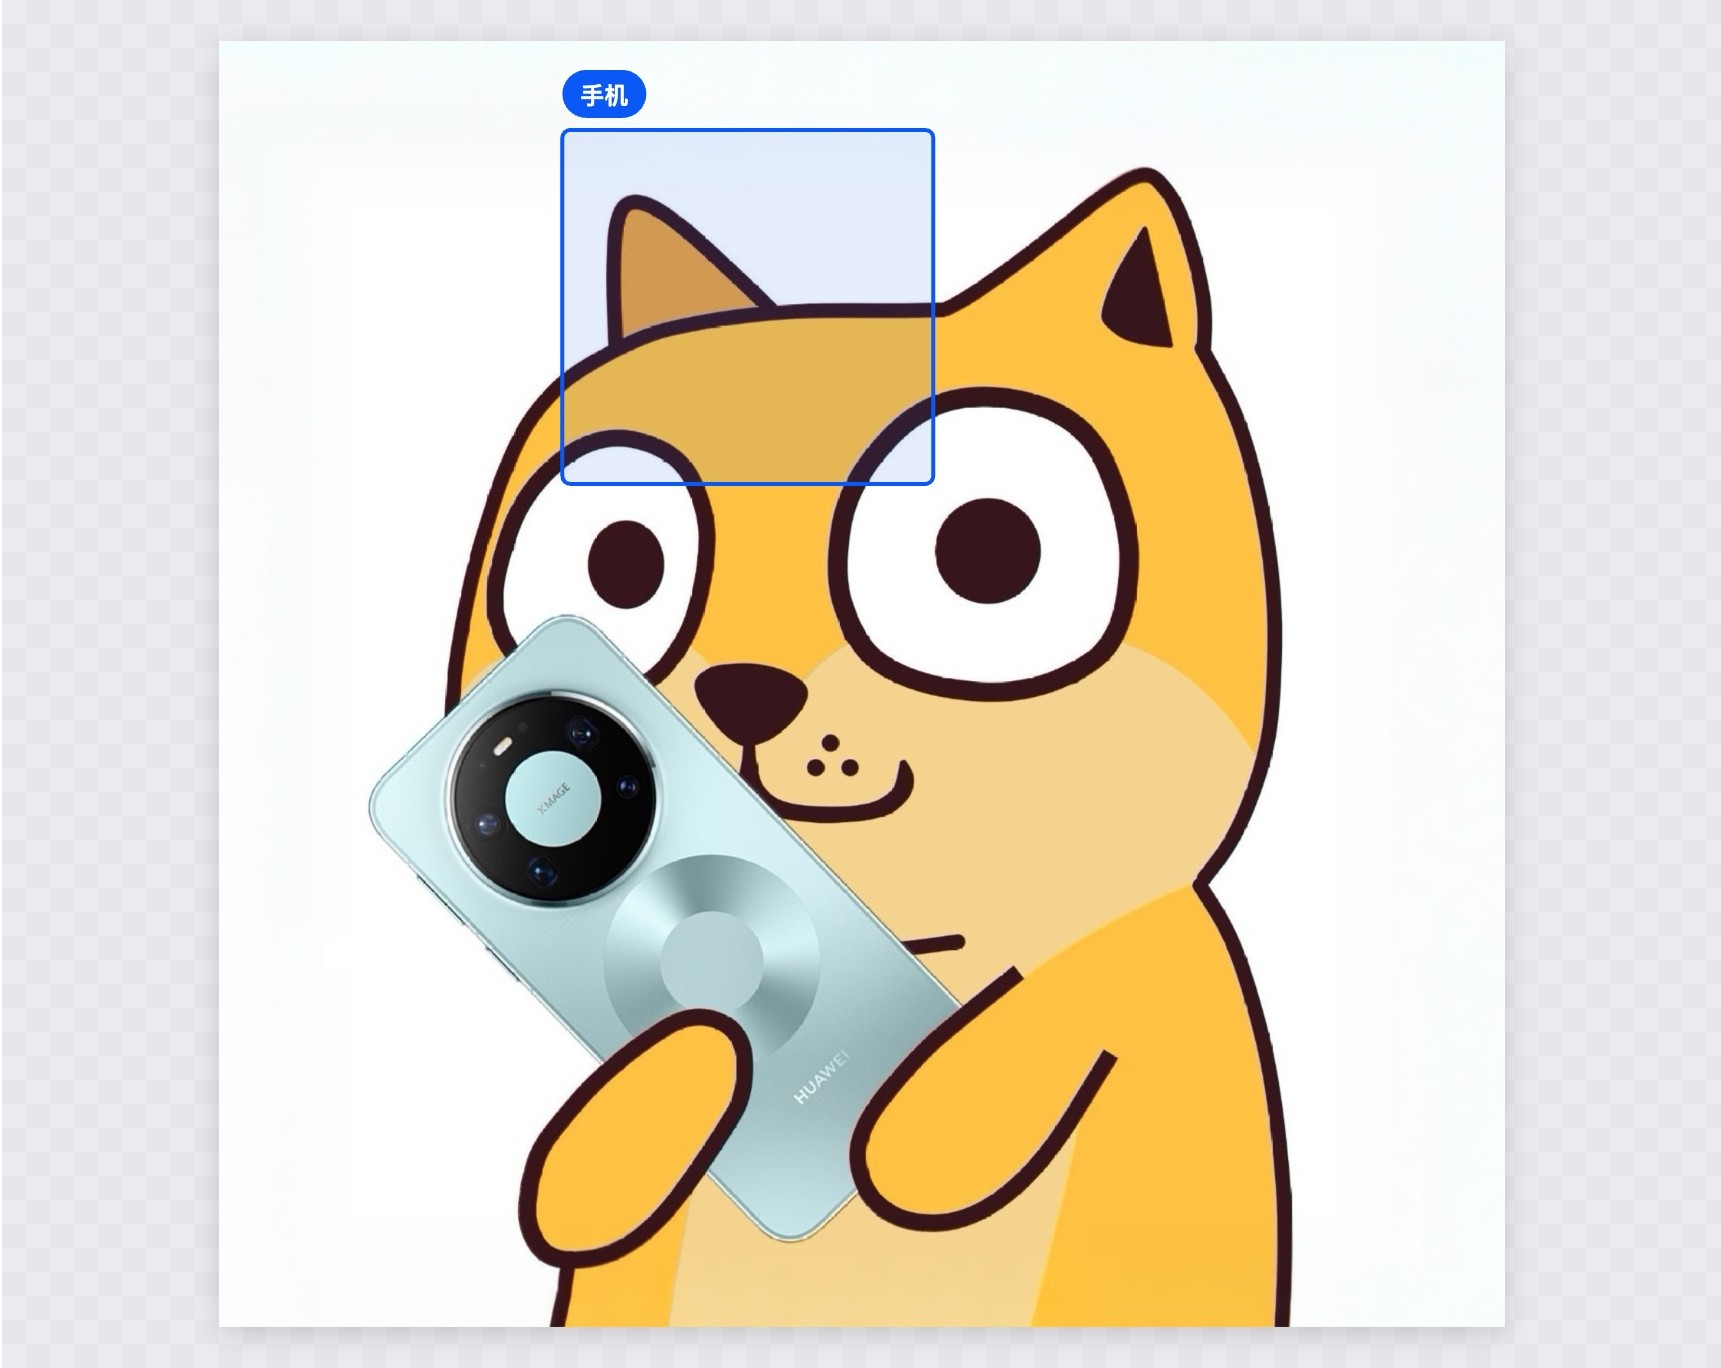
这个任务里面 GPT 完成的最好,完整标出了手机四个角
任务四:网页复刻
原图:
原图
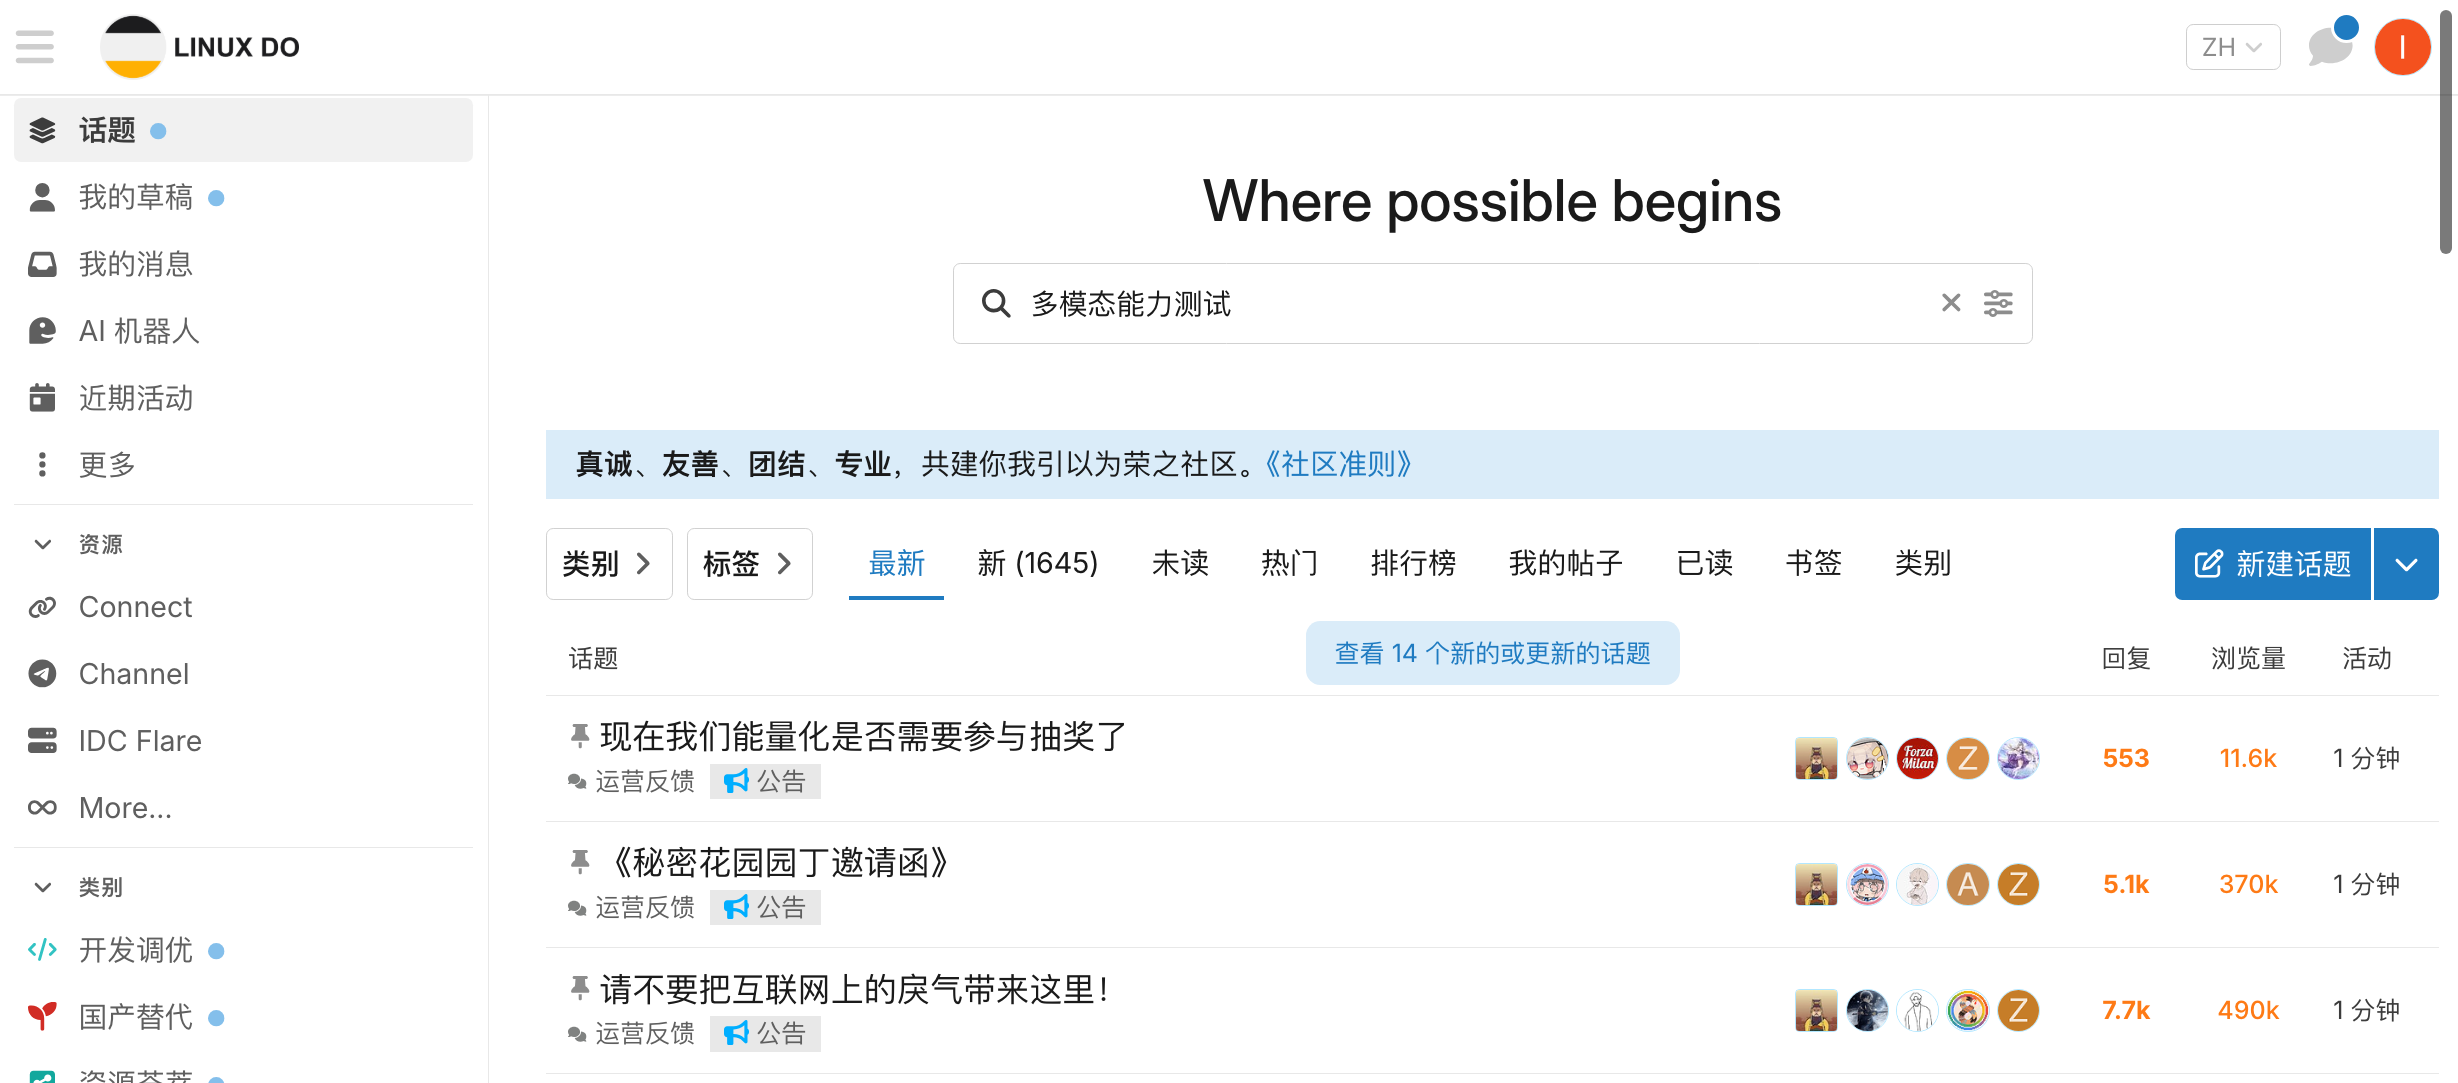
图源站点为LinuxDO(若违反规定可删除)
Gemini:
Gemini 由于不能网页部署,就直接放个截图吧
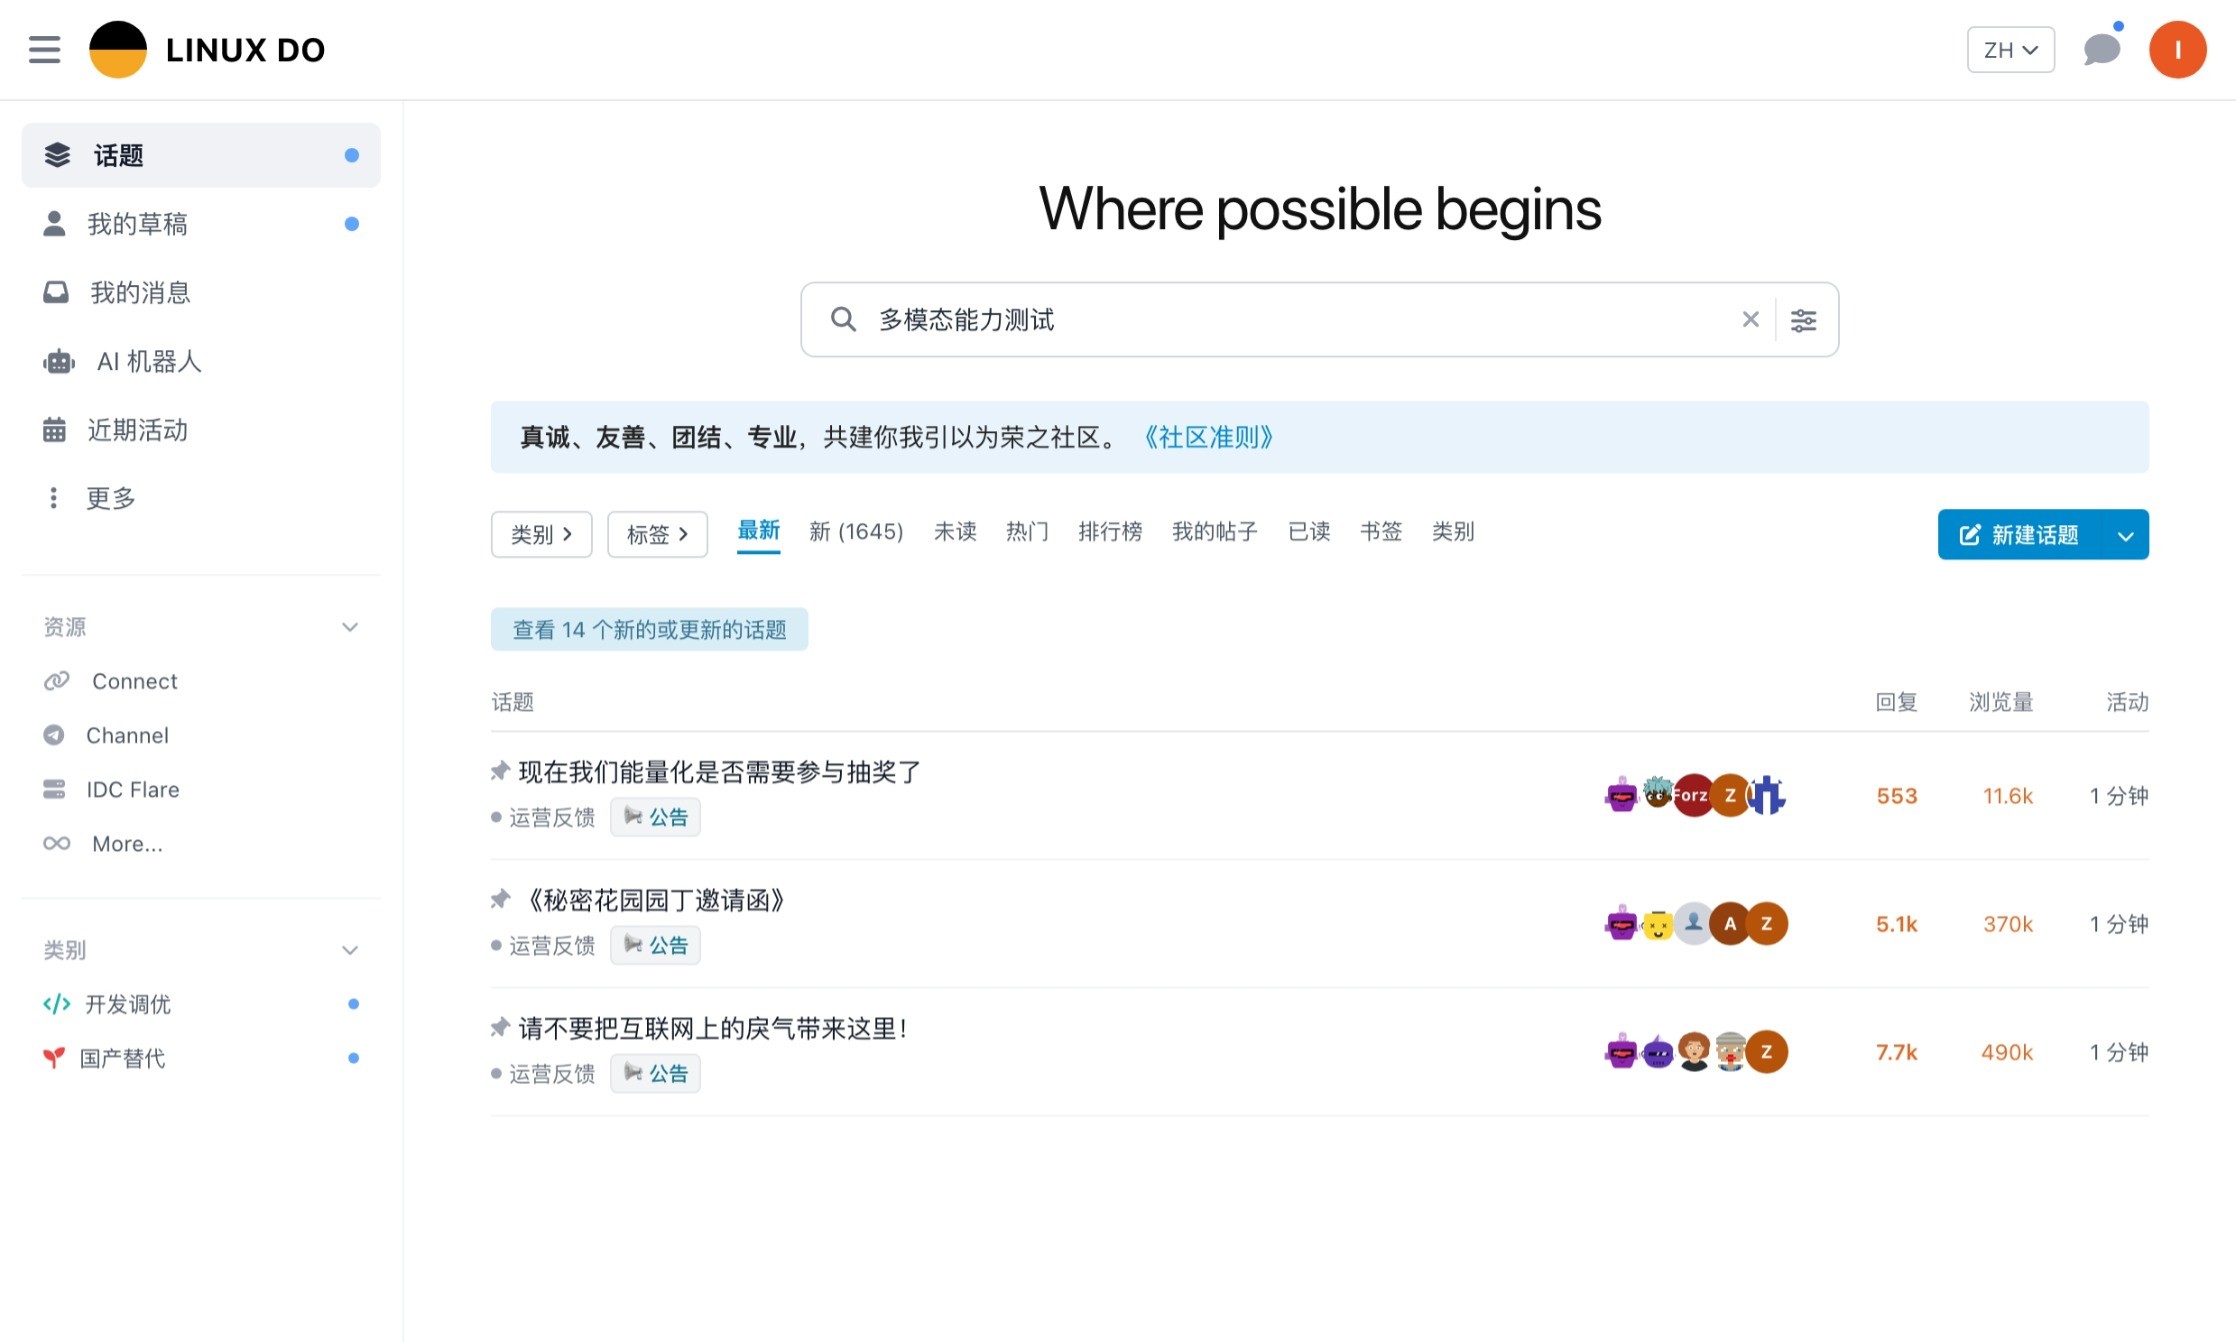
效果还不错,不过用时不到一分钟,可喜可贺!
GLM:https://chat.z.ai/space/u1h8t7r8we30-art
还不错,但是思考时间偏长且部分细节未还原
这个杀死比赛
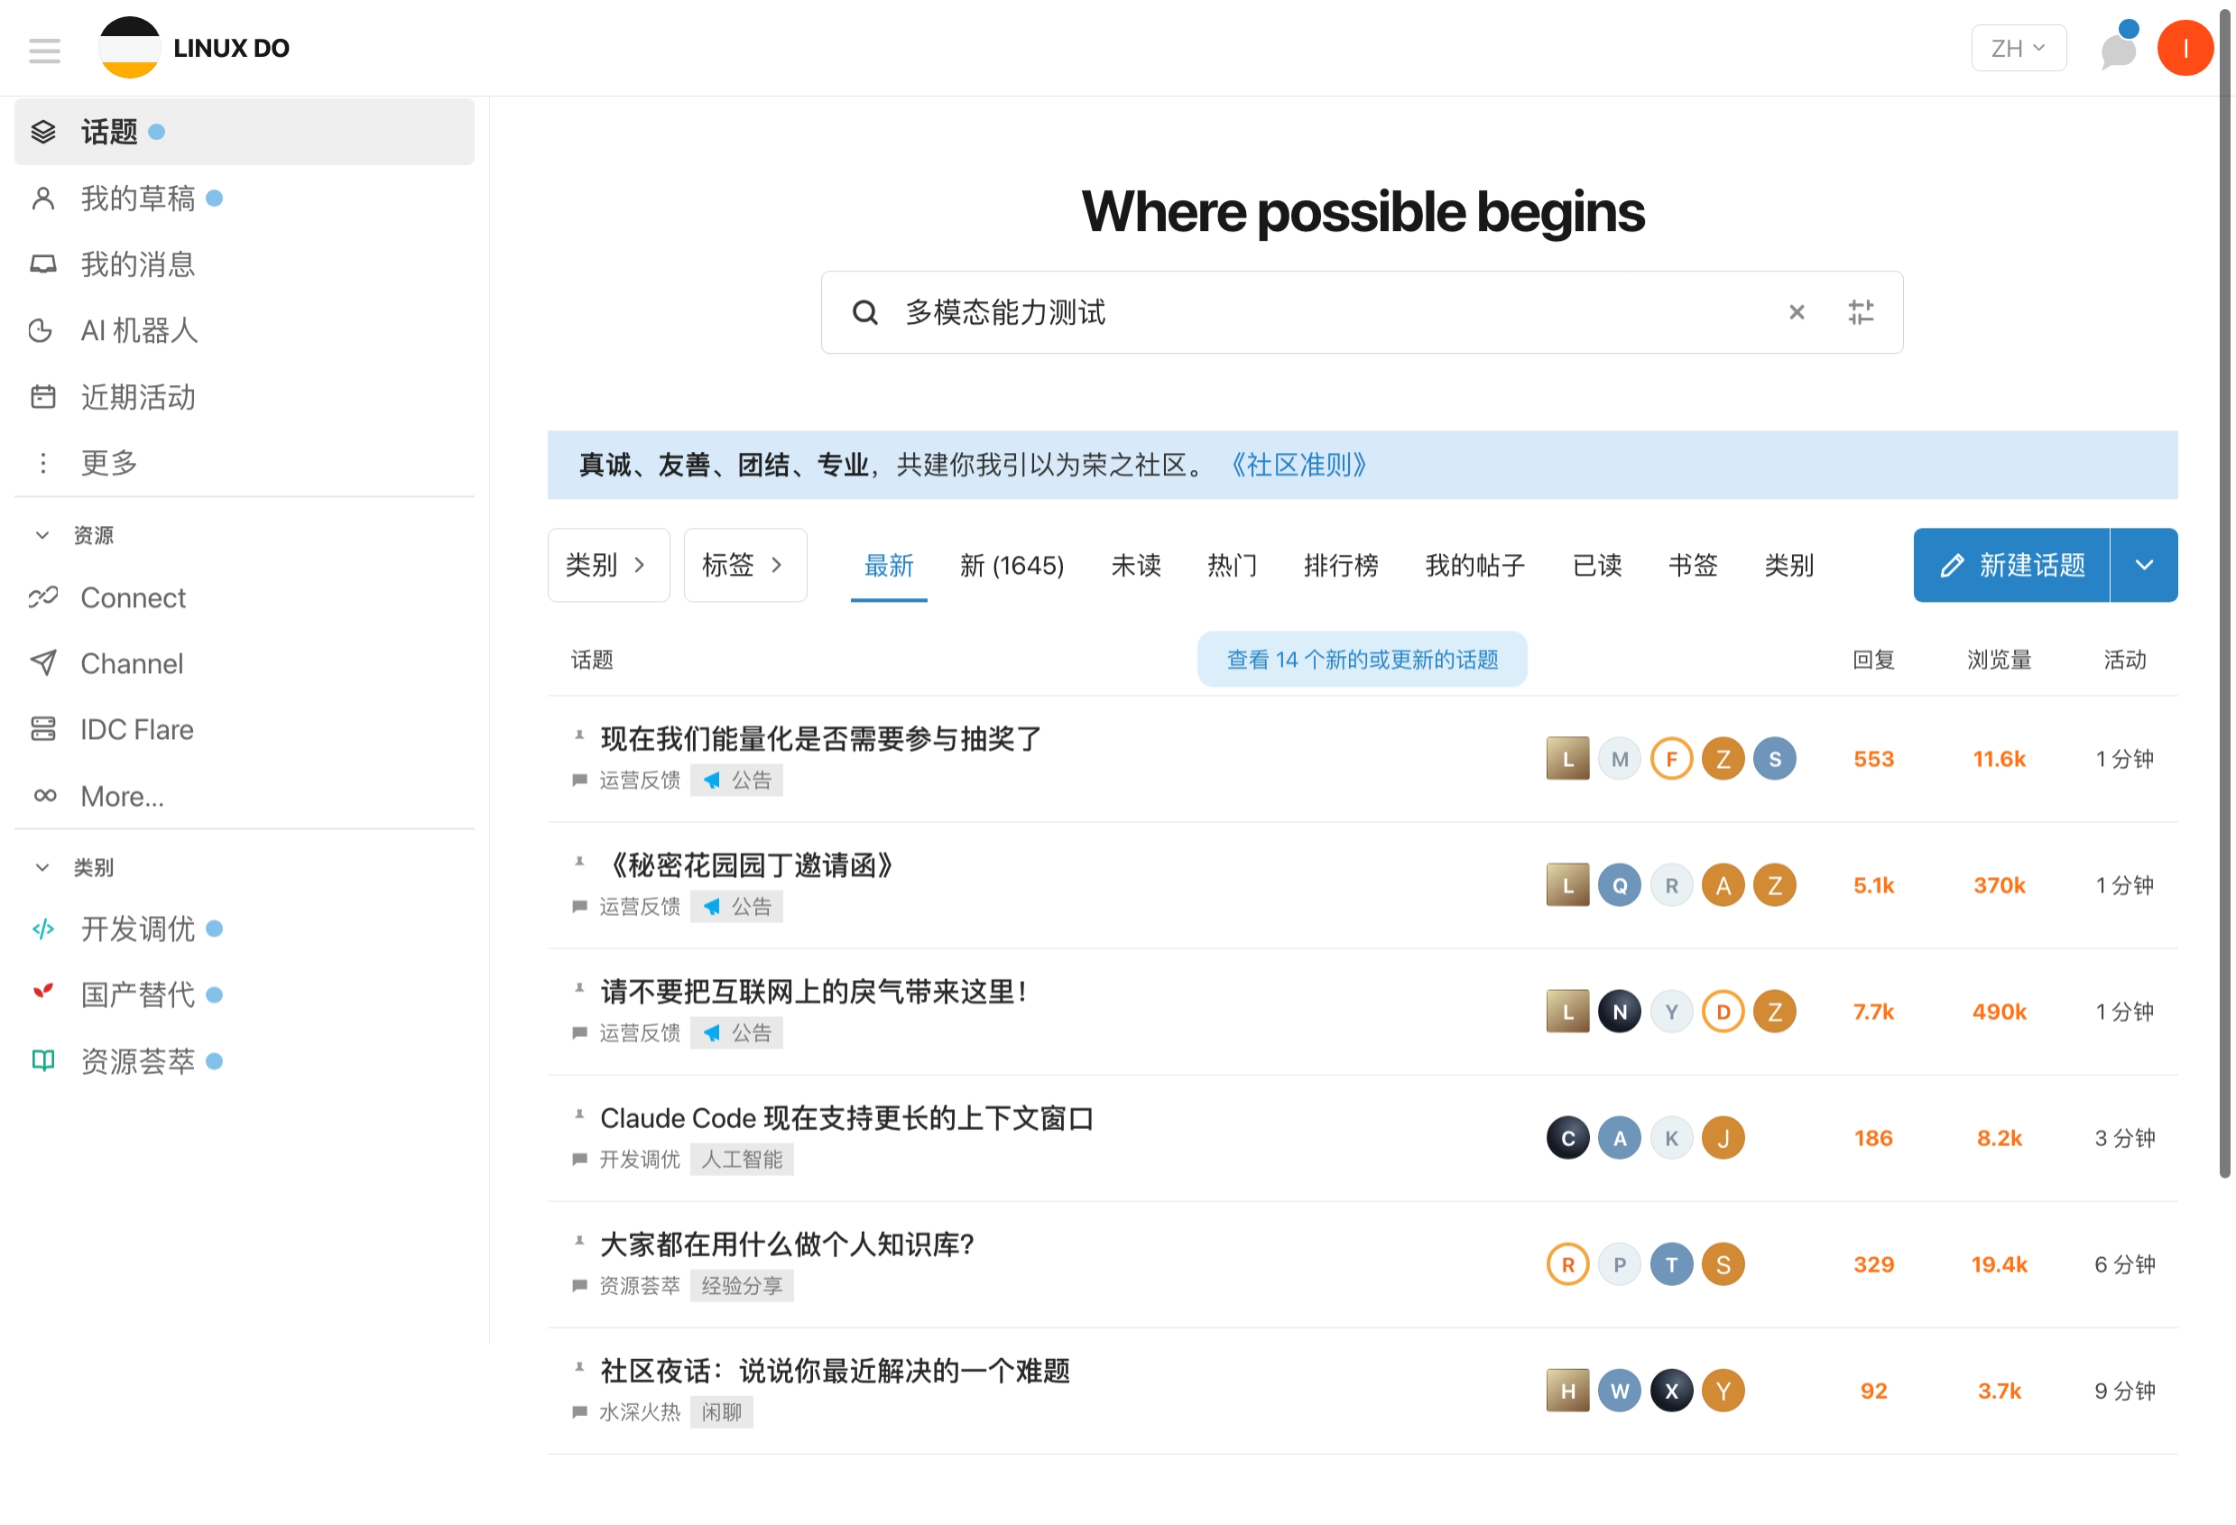
各位可以先猜一下这是哪家的模型,说真的,不细看真的看不出问题
他就是GPT 5.6 sol (网页端 work)!
塌房了,GPT 系的复刻能力真的强的可怕!
总结
看完测试,那有人就要说了,诶老三老三,你这测出来效果和友商比也不行啊,沸腾啥?
欸,当你想出这个问题的时候,你就已经输了,因为这款模型参数量只有320B,激活参数更是只有可怜的 18B
什么概念?
kimi K3 2.8t(2800B),激活参数104B;DeepSeek v4 pro 1.6t,激活49B
更别提闭源的 GPT 和 Gemini 系了,glm 能这样四两拨千斤,确实难得。
但同时,我也有些隐隐的担忧,首先就是智谱家的模型coding plan 天天涨价,据不可靠信源透露,目前官价 api 5 折折后比自家 coding plan(V2/V3)便宜,是的孩子们,能随便外接,速率限制很宽松的管渠api 居然比 coding plan 还便宜,智谱的定价也是没谁了;其次就是“降智”问题,有人说,coding plan是国内机房的 fp4,但管他呢,总而言之,这个模型就是神区二象性的代表——**降智前配上价格就是神,降之后就是区,还是最烂的区。
整个测试下来,我认为满血版GLM 5.3 Flash绝对是顶尖水平,现在有人评价封神,有人评价区,我觉得更多的是智谱这个公司在运营策略以及算力部署方面的问题。因此,我肯定 GLM 5.3 Flash 的进步,但不推荐任何人购买/使用现阶段智谱部署的GLM 5.3 Flash。