引言
今天中午还想着梁叔叔涨价了还拉胯了,不知道智谱能不能接住这泼天的富贵,打开 it 之家,您猜怎么着
GLM 5.3 上线了
看得出来 这次的标题就和前两次的雷霆风格很不一样。因为这次智谱确实打了个翻身仗,值得细细评鉴。
先说暴论:
如果你是一个手头预算有限,有 coding 需求和一定的基础 coding 能力,并且手上确实有任务的电教委员,智谱(老套餐)可能就是你最好的选择
为什么这么说呢:
首先第一点,以 V2 套餐(这里解释一下,智谱编程套餐经历过两次涨价,我们称最开始的套餐为V1(当前已经全部被迫升级至 V2),第一次涨价为 V2,第二次涨价(也就是目前官网在售版本)为 V3)为例,149/月的价格确实不贵,和友商(kimi DeepSeek)比性价比不知道高到哪里去了
第二点,智谱恶心的峰谷价机制对于在校学生来说是重大利好,你想啊,那周一到周五的高峰期大家都在学校,基本产生不了什么用量,周末/每天晚上(18:00之后),大家才真正能够摸到电子设备,开始 vibe coding,疯狂消耗额度,此时的计价是0.67倍,天助我也!
第三点,国内订阅方便很多,且使用方便
第四点,就是今天这篇文章的重点:模型能力超强。
实测
后端
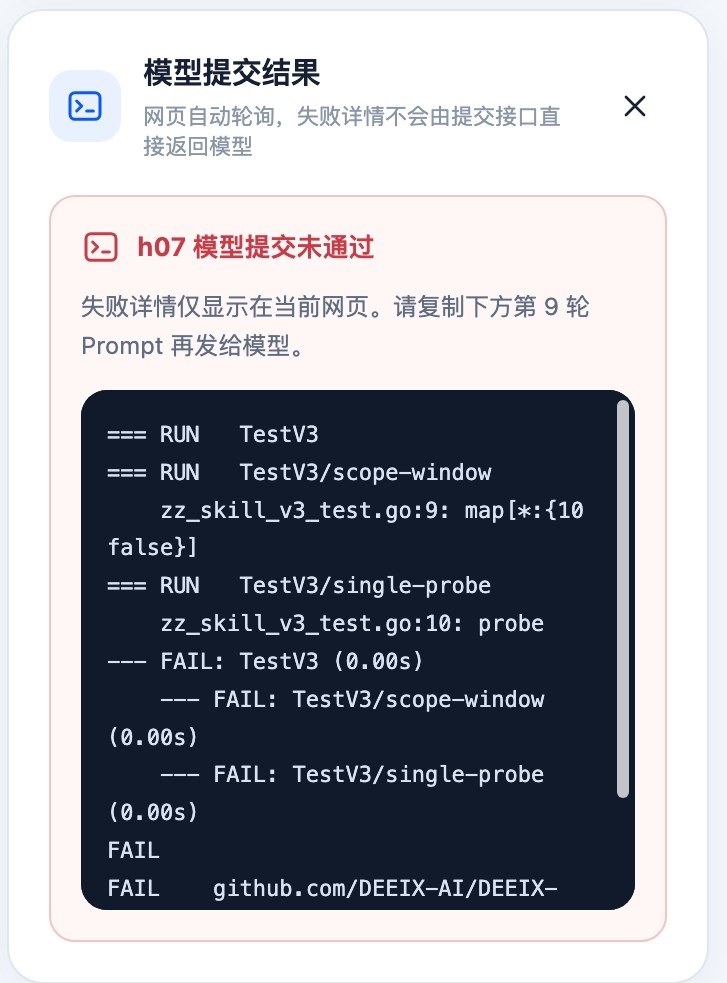
本次测试依旧是祖传测试集,选取我个人认为非常难的题h07进行测试
GLM 5.3 使用了 8 次机会
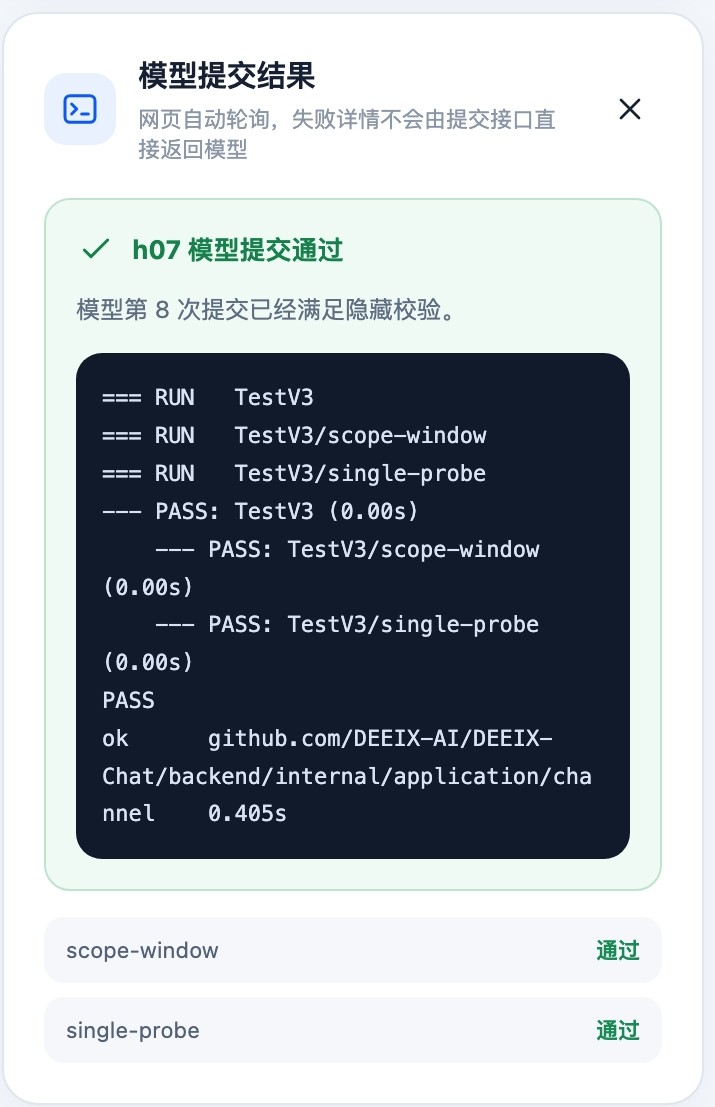
看起来很多,实则是非常强悍的水平!
因为连这道题的出题者,GPT 5.6 sol(max)都用了 至少(不忍心看 token 像瀑布一样流走,没测了)9 次
注:大模型本质为概率模型,同时也不排除远端模型降智,部分测试可能有偏差,但本人保证该测试结果为正版 codex、openai 官方coding plan、全程思考预算为 max
前端
| 模型 | DeepSeek v4 Pro GA | Kimi k3 Max | GLM 5.3 |
|---|
| 备注 | 复用上期,不解释 | 复用上期,不解释 | 使用了谷歌字体,建议配置相关网络环境 |
| 演示地址 | 点这里 | 点这里 | 点这里 |
我觉得是很有创意的,和 kimi 相比虽然还是有点差距,但是价格方面完胜!并且速度方面也稍快一些。
官方Harness 工具(Zcode)
相较于几个月前的套壳 opencode,现在的 zcode 可以说有了质的飞跃!
从工具调用方面就很明显,别家模型之前接进来是真的会降智的,经常工具都用不明白,但现在完全不同了!而且就是虽然之前智谱就有官方识图 mcp 来弥补没有多模态能力,但是没有内置,现在因为是自己的客户端,直接内置在里面了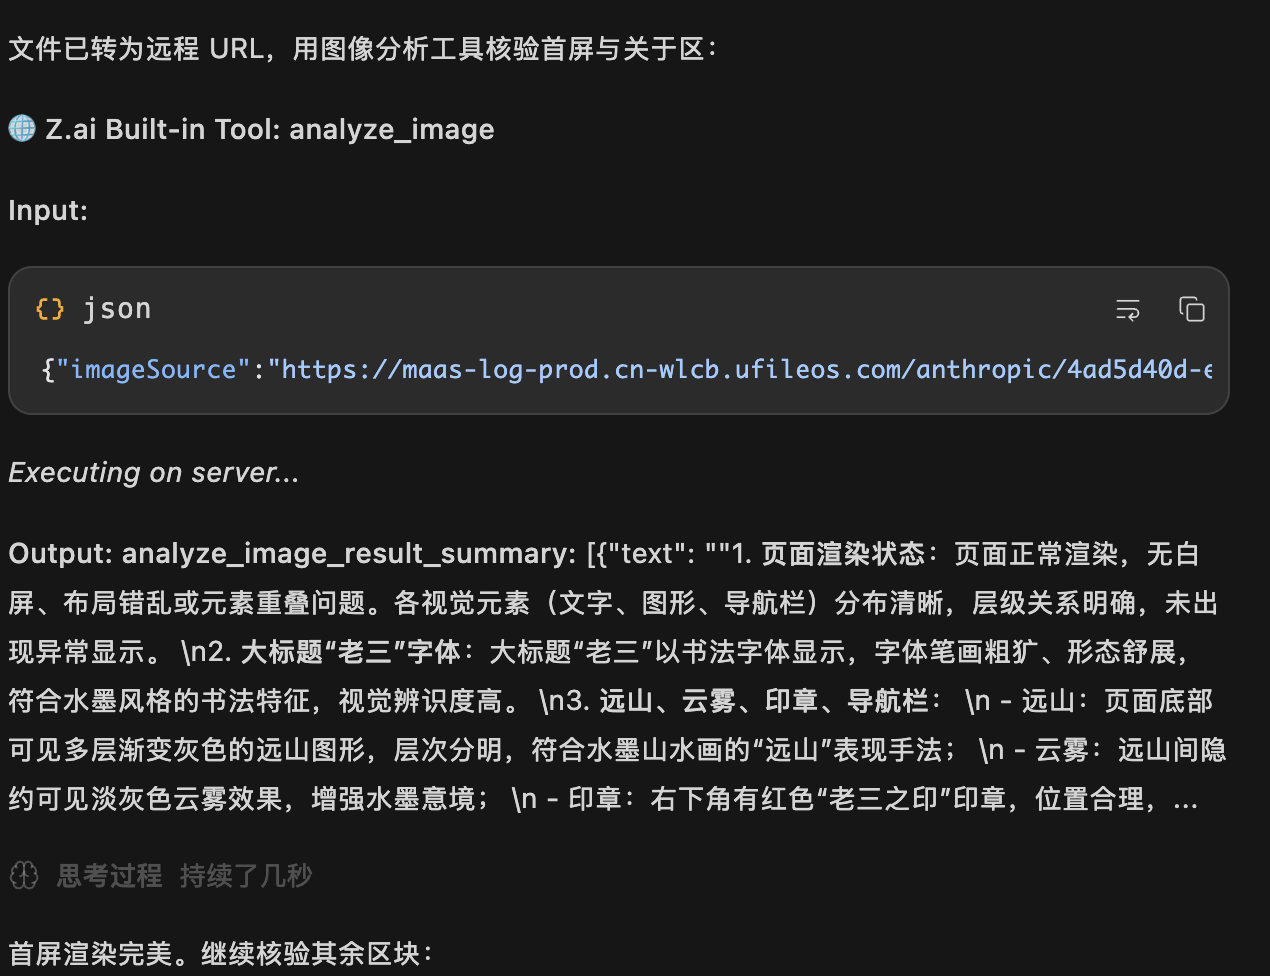
整个界面虽然有抄袭学习友商的嫌疑,但是非常易用,别家模型想要接入也不用像友商那样重启生效
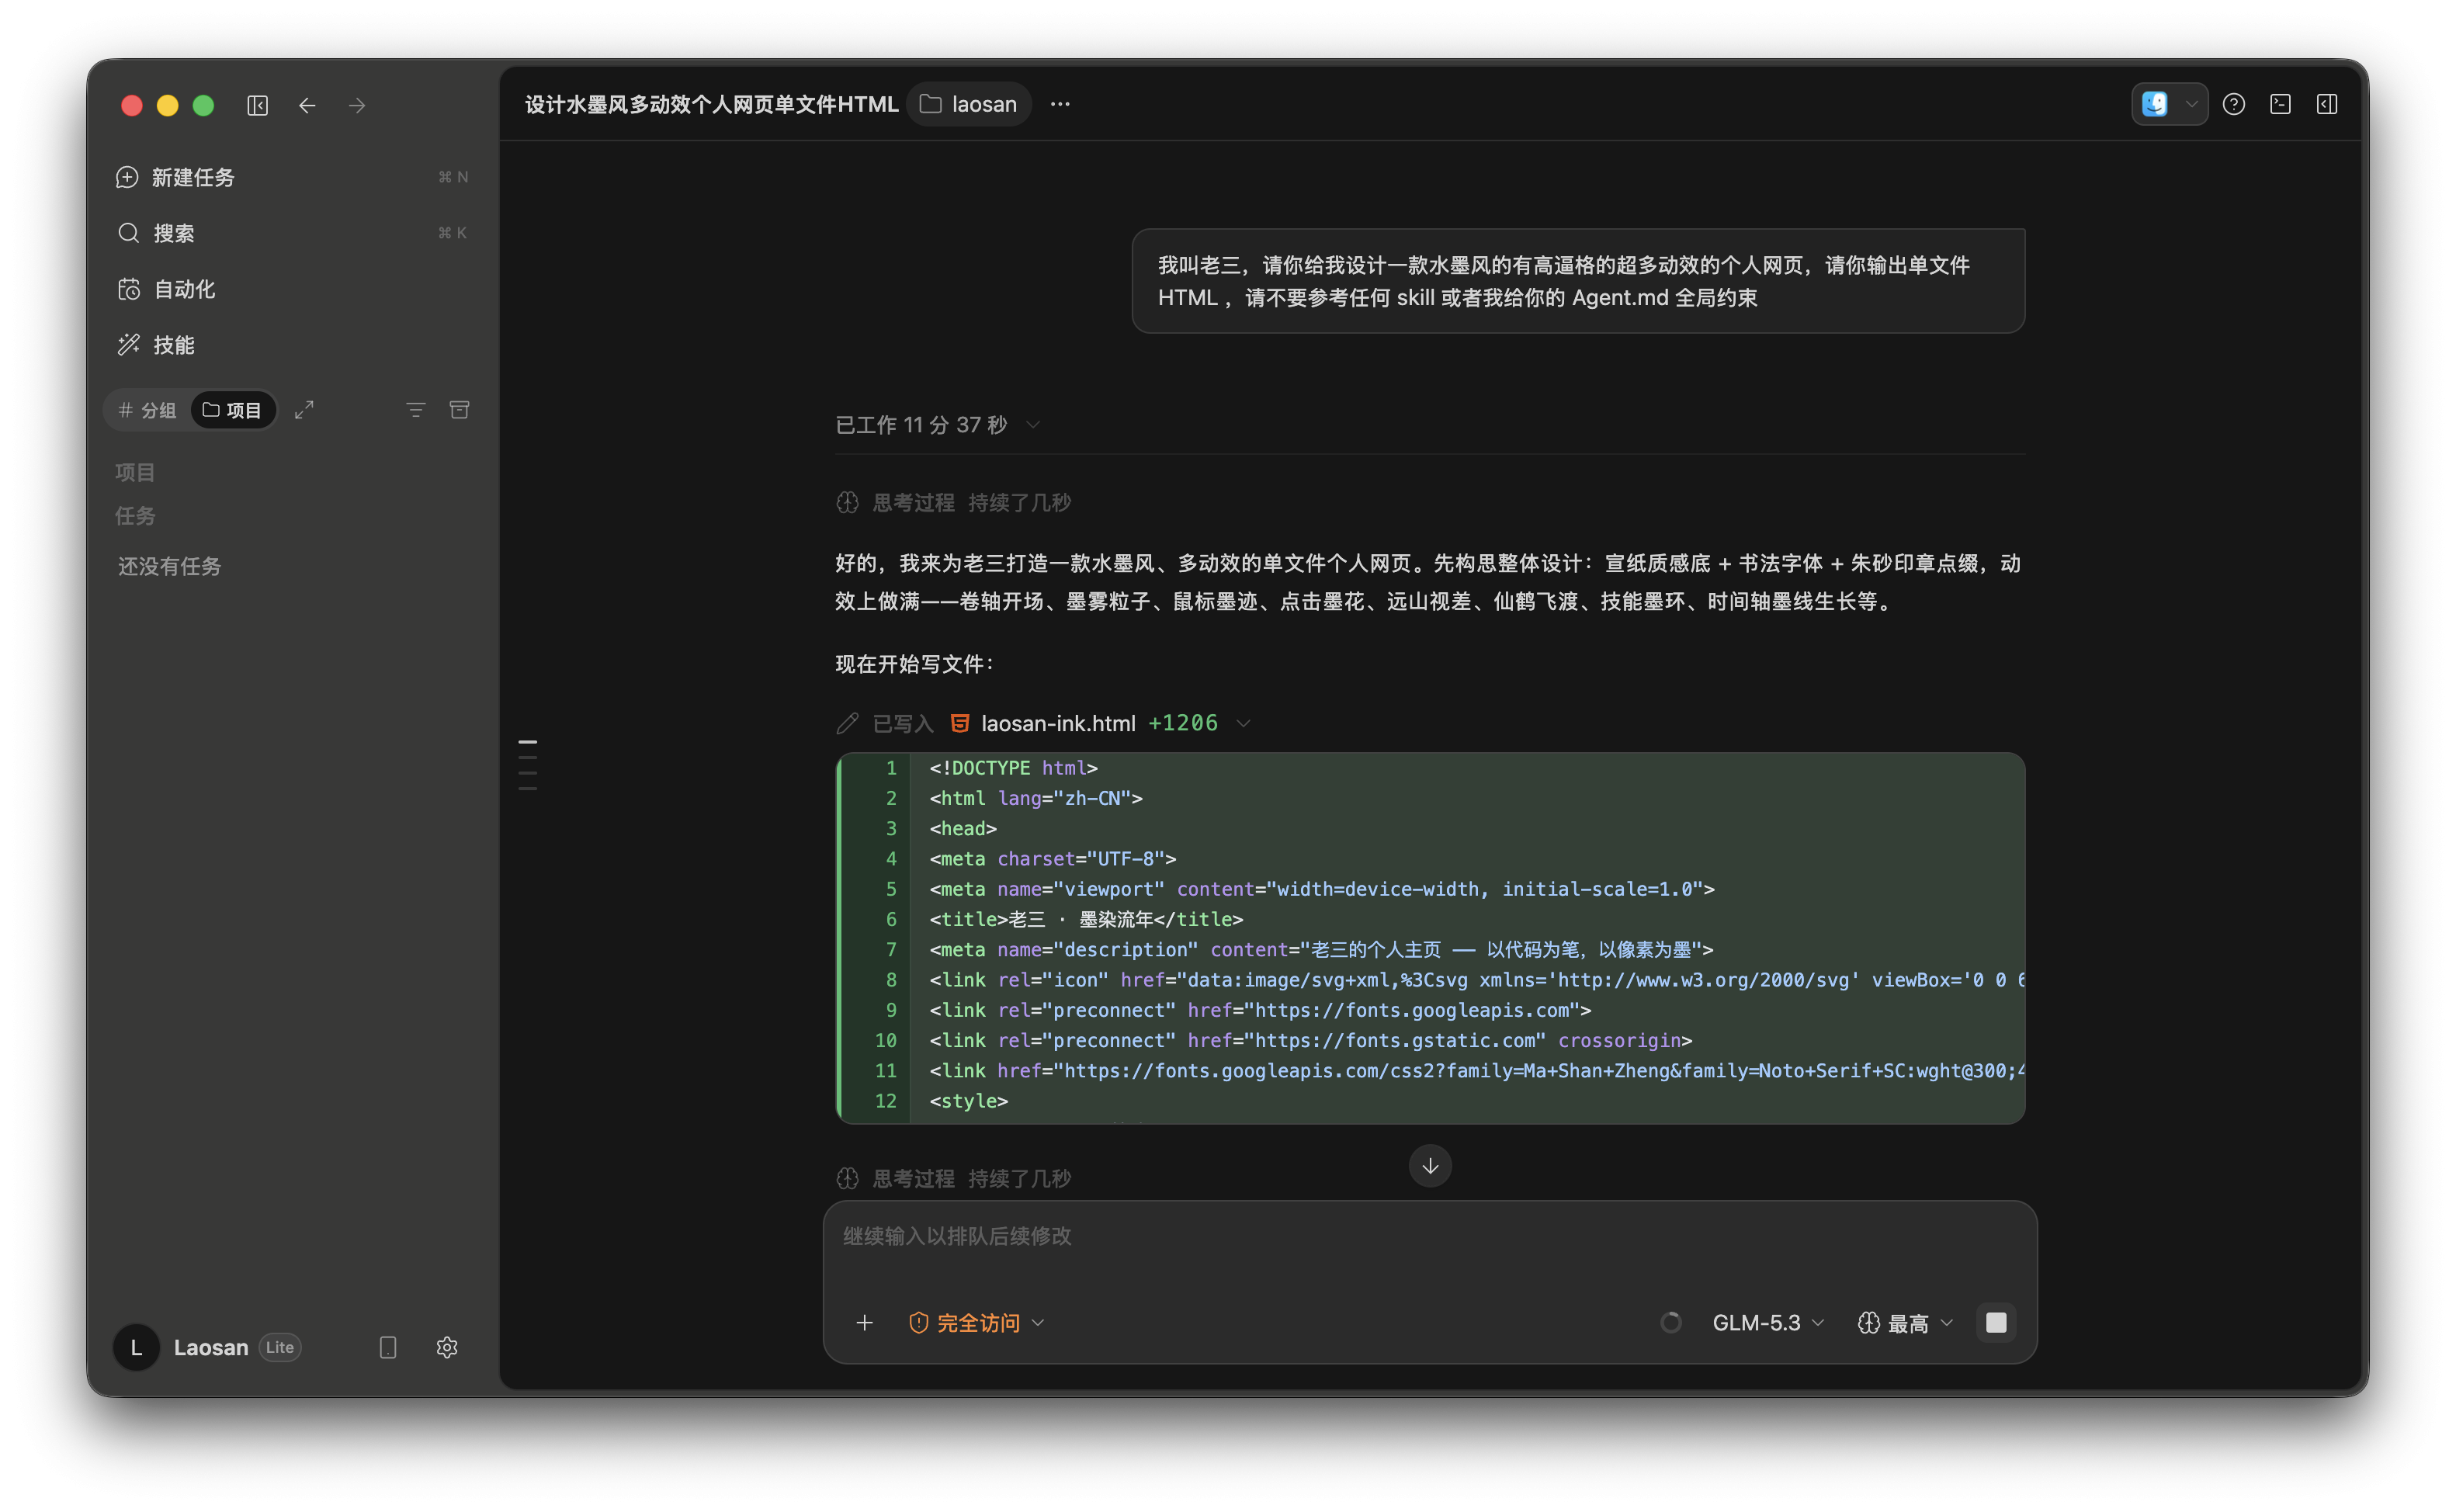
更难能可贵的是,他支持直接导入 CC/Codex 的相关内容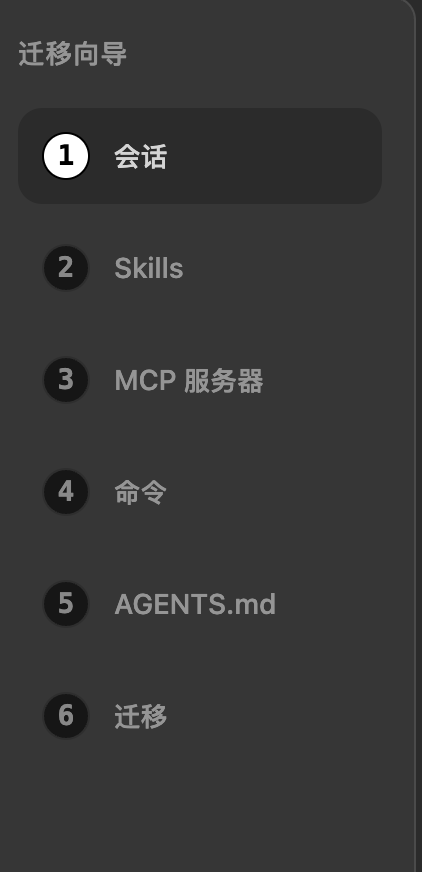
迁移成本真的几乎为零。搭配自家 coding plan 还有额度加成,现在用 GLM 不用 Zcode 属实有点说不过去!
文本创作
国内模型:
海外模型(需特殊网络环境):
结语
购买建议
如果你是在校中小学生,那么V2版本的 Pro套餐是最适合的——基本够用的额度(记得加上 zcode 的 150% 活动)、无法被峰谷价选中的你自己、简单的购买/使用方式是非常合适的。但如果现在直接在官网购买 V3 套餐是非常不划算的,所以我建议有 V2 的续费,没 V2 的去闲鱼收一个 V2(现在有溢价,找便宜的看着买就行),但要注意购买之前询问卖家(小声逼逼:有一说一,这些人真的有先见之明,当时我看到智谱二次涨价之后(到 V3)还没发新模型就取消了自己的 pro 续订,没留得住 pro,结果只能吃 lite 这坨狗市了……大家千万别学,这 lite 的 5hr 限制超级少,随便用两下就没了,我后面是去海鲜市场买了个老 pro 才苟延残喘的用下来的)
1.是独享还是拼车:这点很重要,拼车很影响体验的,本来 pro 就只是勉强够用,万一车友不讲武德全用完了也没人说理
2.是直连还是中转:如果是中转,我建议你三思而后行。中转站是个黑盒,他给你路由成豆包都不奇怪
3.是否已经使用过(周限/5hr 限制):这点没问的情况下可能会买到已经使用的账号,这是直接影响你利益的问题,如果有使用过的可以让号主改价(指不定还能捡漏)
但还是要注意:如果你觉得你近一个月不会使用这么频繁,只会在某些时候用用,那么可以等等它开源。等第三方厂商自部署把价格打下来再入手也不迟
瞎逼逼
这篇文章是我在边测、边用、边写的过程中完成的,期间经过了大量的删改。GLM 5.3 刚上手的表现就让我非常震惊,特别是在处理h07那道题时,我自己盯着题目看了很久(实则是翻了验证器答案和原有的正确代码)才恍然大悟;原本预计它可能需要 10 轮左右的修改才能做对,结果它的表现狠狠地打了我的脸。这份惊喜促使我一边跑着测试,一边直接让它参与到我的真实项目中进行开发——事实证明,它绝对是一个一流的模型。无论是在后端工程的构建,还是前端审美的把控上,它的表现都极为出色,在脱离 Benchmark 的实际工作场景中也极其能打,甚至在我的个人项目里直接贡献了不少可用性极高的代码。客观来说,它的前端能力与 Kimi k3 相比还有一定差距,但后端能力绝对不输、甚至可能超过了 k3(注:这里的“超过”仅基于我个人的单个测试用例与主观体验,不代表全面的事实能力),整体后端实力已基本比肩 GPT 5.6 sol(至于 Claude,因为我的号被封了暂且无法评价)!如果按智谱常规的几百 B 参数量来看,能用这样的参数规模达到如此强悍的能力真的非常了不起,更难得的是,在编码能力大幅提升的同时,它的文学表现也没有出现明显的退化。智谱这家公司确实展现出了极强的技术底蕴,真心希望国产大模型能早日追上真正的 SOTA!
至于 DeepSeek——我祝他们好运。
2026 年 8 月 14 日 19:26:59 补充:隔壁站有人说这一代在瑟瑟(NSFW)方面强了不止一点……嘶……不方便放出来,各位可以批判性测试一下,不要贪杯 不要贪杯 不要贪杯!!!!!!!!
参考文献就不放了(