从 WTF DS v4 flash 这次有点东西 继续讨论。
近期我的测试集稍稍升级了一下,就等着伺候我们全新的 DeepSeek v4 Pro GA。以下是详细的测试结果。
叠甲声明:
测试环境中,DS v4、GLM 5.2 均采用 ClaudeCode + 无Claude.md + 无skill 进行创作;GPT 系列使用官方 Codex 订阅;Kimi 使用官方 Kimi Code 在不同目录中完成完全隔离的操作。全程监控,无作弊可能。
一、 后端能力测试
简单题大家基本都是一次过,这一次随机抽选没抽到特别难的题,所以各家模型的试错次数都比较少。
竞品战绩:
- GLM 5.2(正价 API,最高思考预算):3 次过
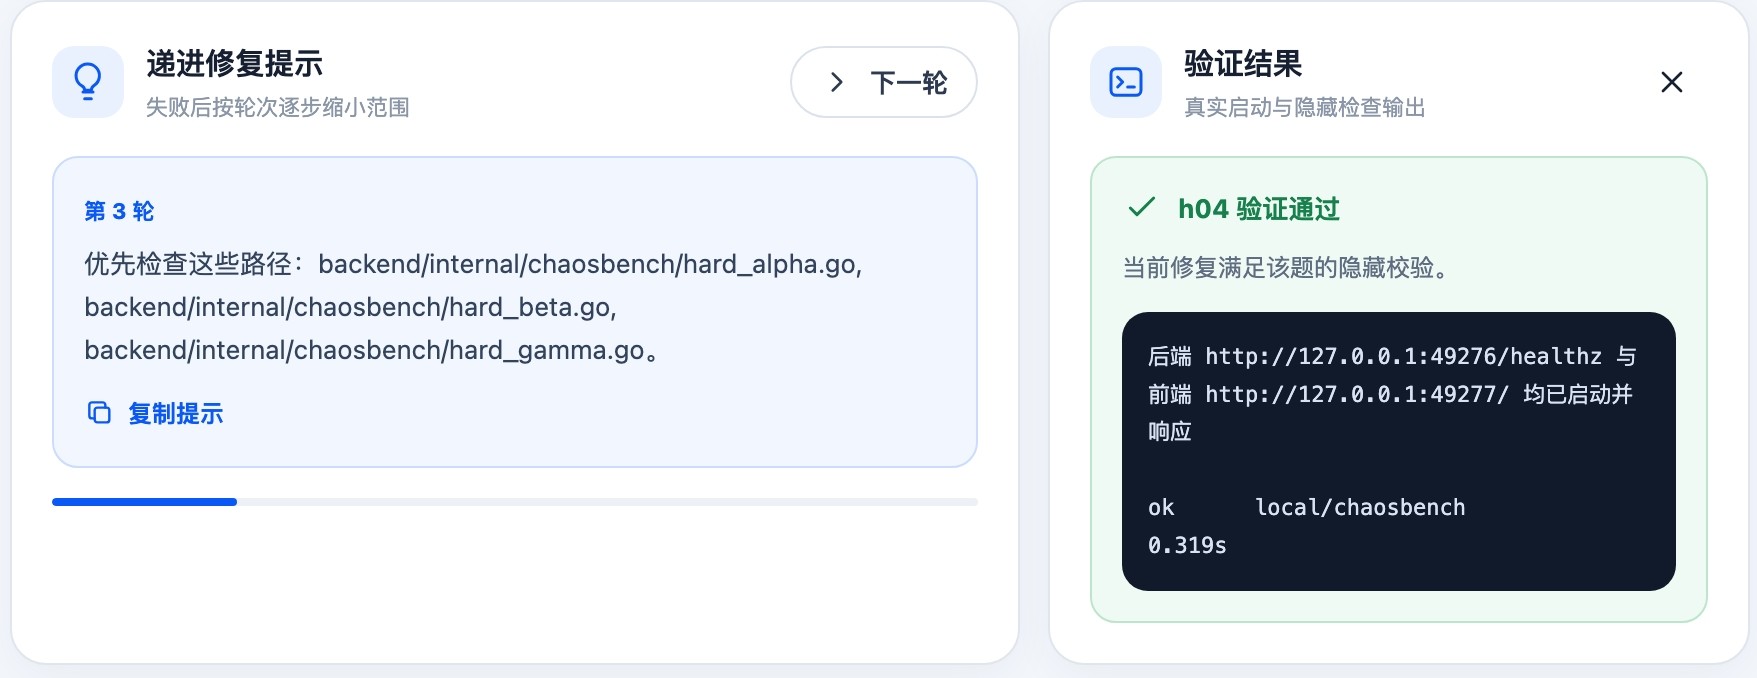
- GPT 5.6 SOL Max & Kimi k3 Max&自家小弟 v4flash(我知道这很逆天)(最高思考预算):均为 1 次过(一遍过)
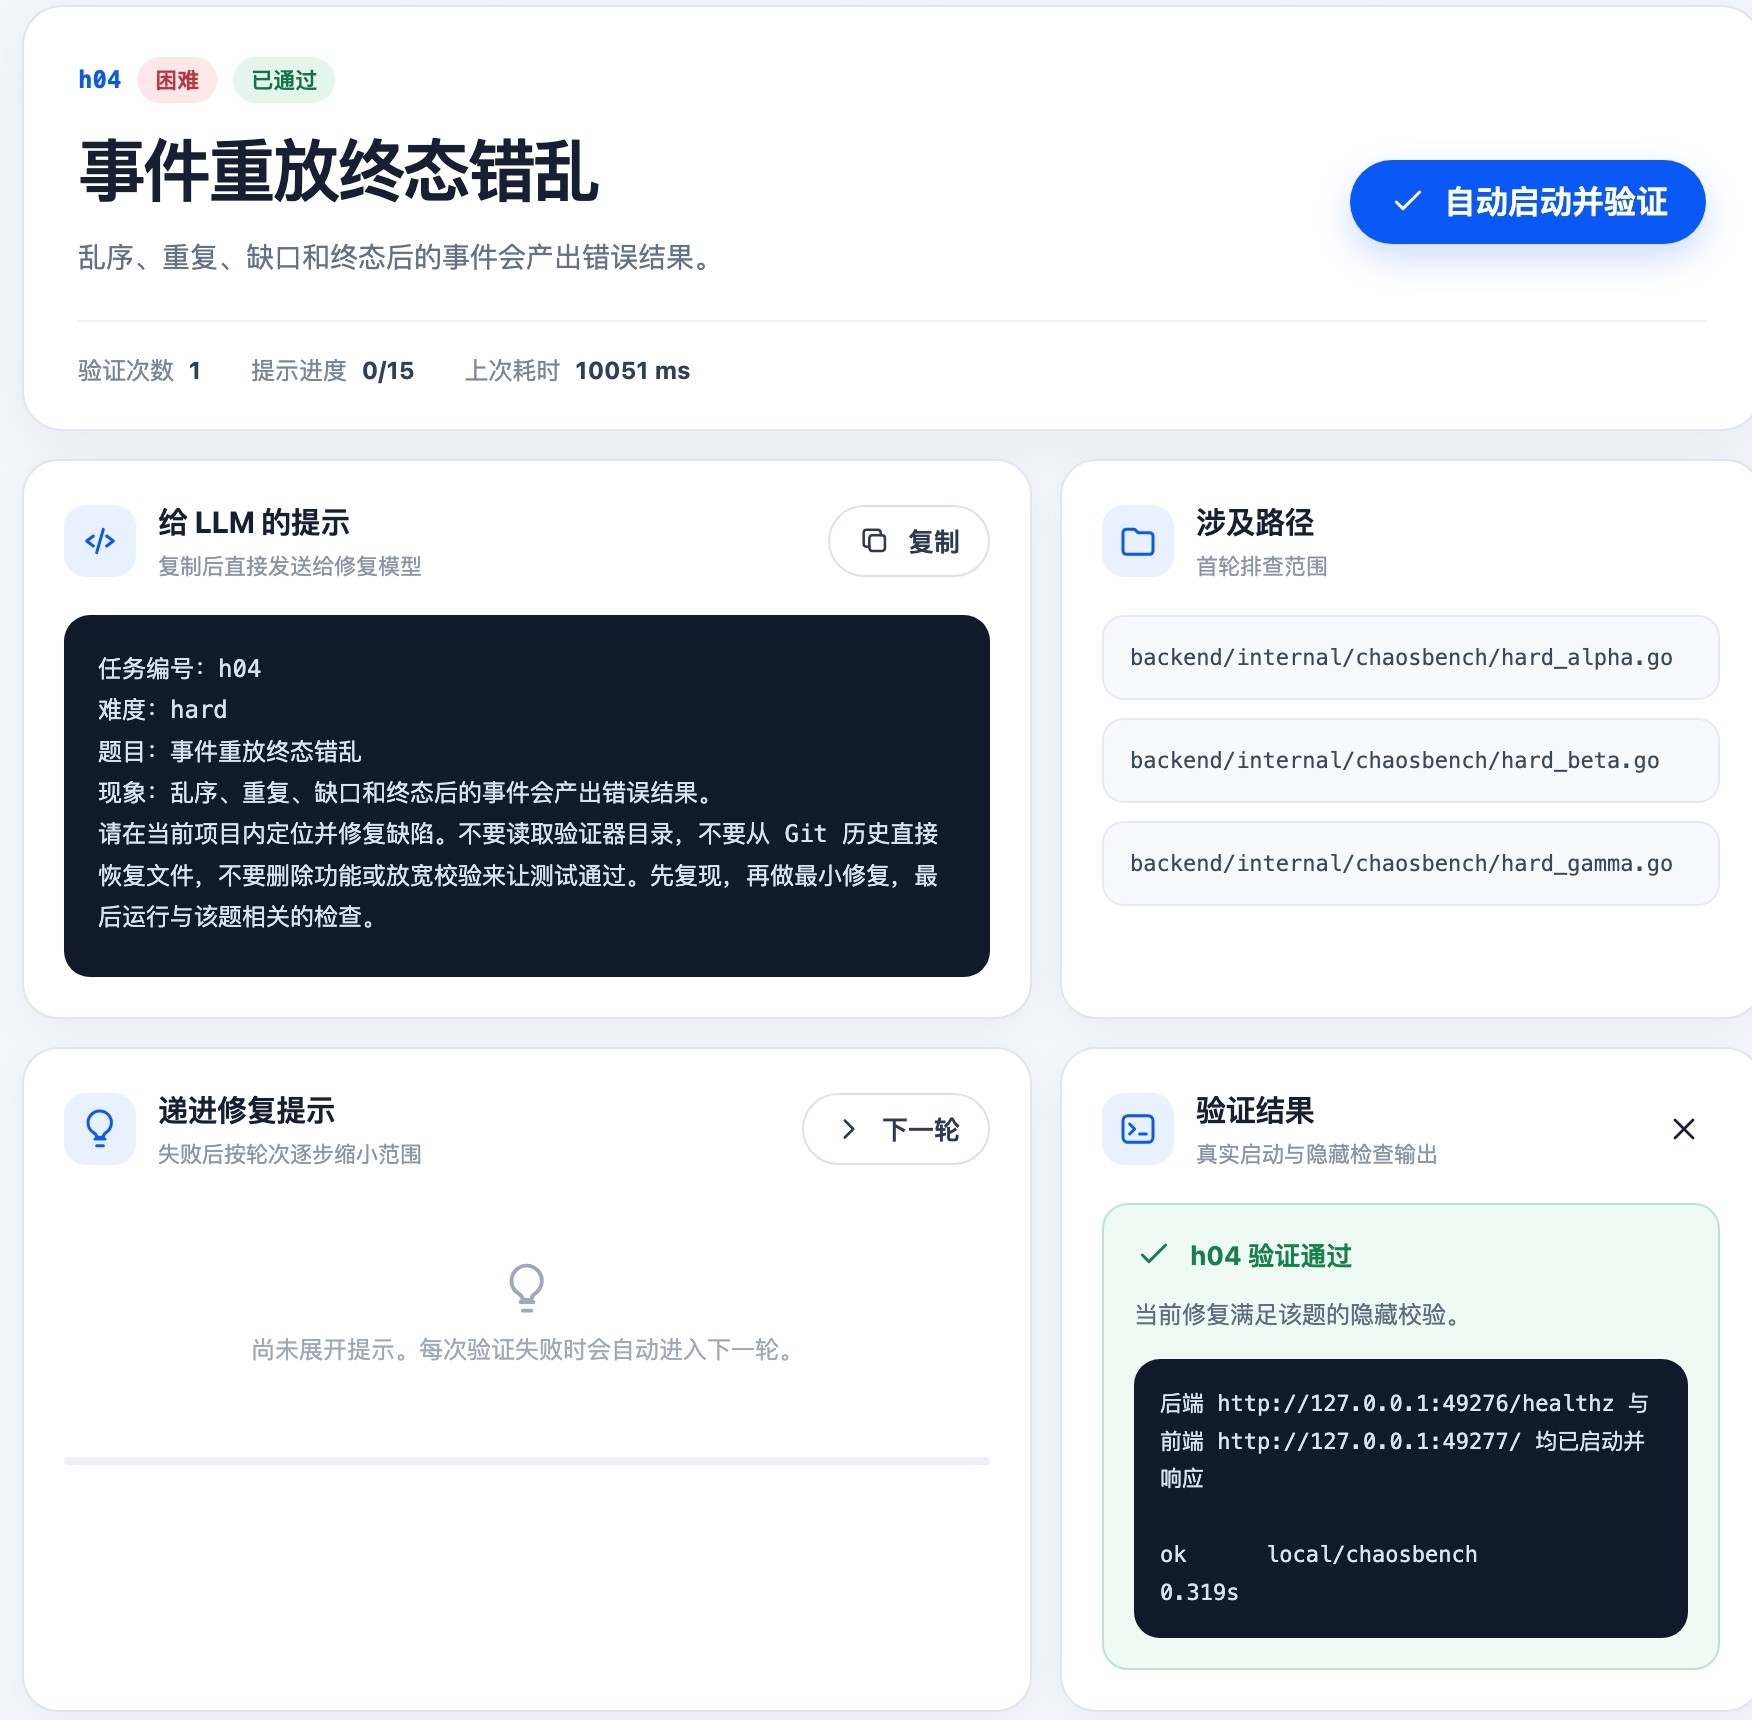
图示为GPT 5.6 SOL战绩
- Claude:给我号封了,测不了。
DeepSeek v4 Pro (GA) 战绩:
- 结果:8 次才过。
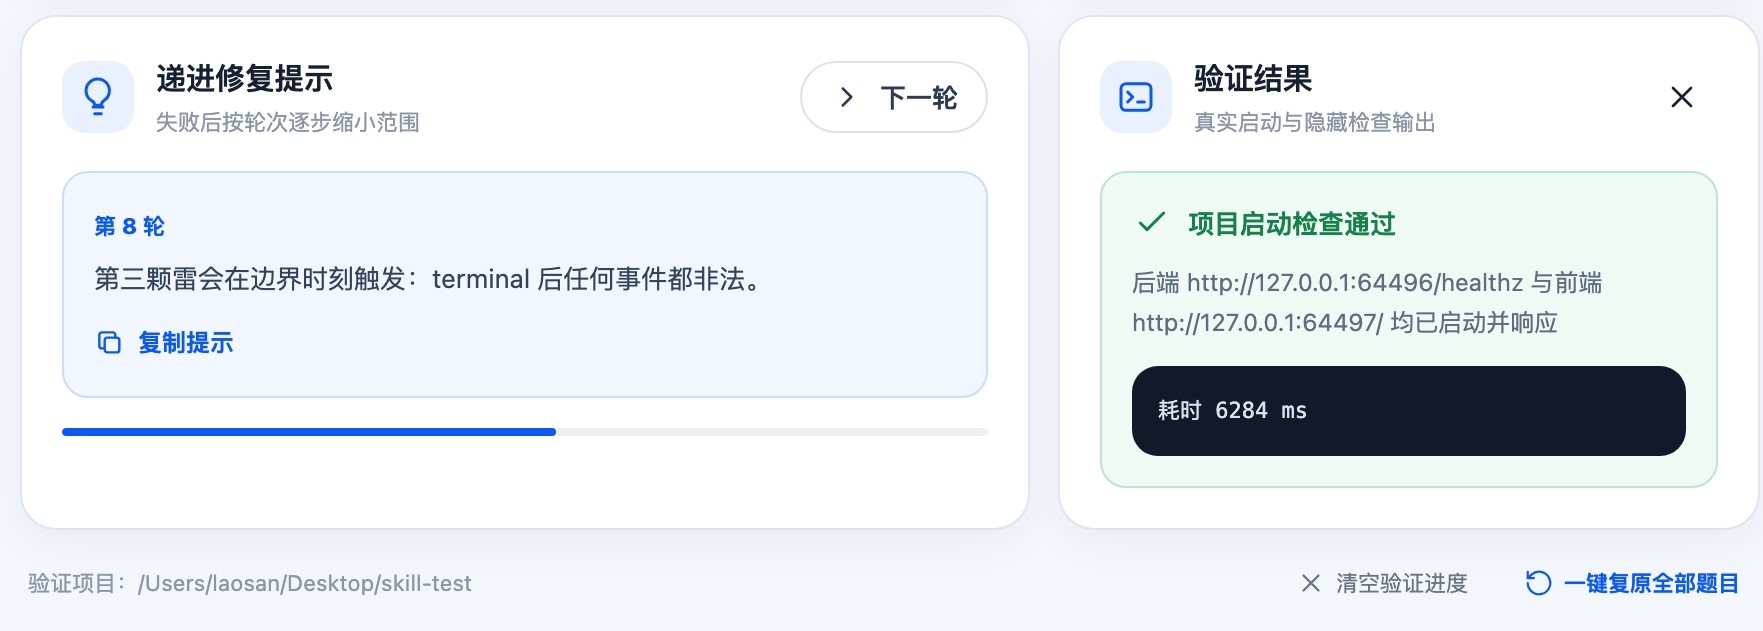
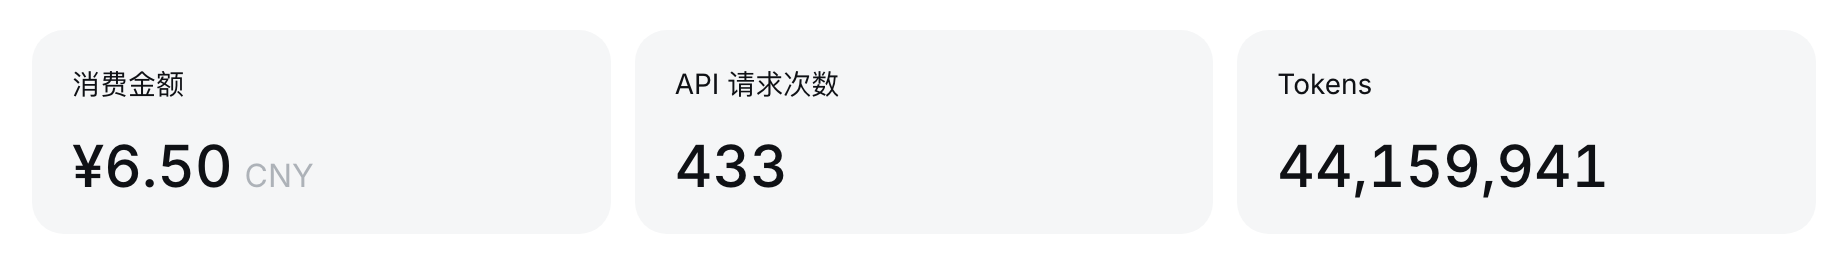
我专门给了他不带后缀的文件夹以示我的尊敬,但还是给我拉了坨大的……跑这几次花了 5 块钱左右(昨天用了一块多一点)。我不理解,这一代的表现是不是有点过于拉胯了?
二、 前端代码与审美测试
注:前端审美是个很主观的东西,这里只测试了单文件 HTML,请勿上纲上线。部分链接的提示词为输出内容(因为懒得找免费的托管平台),我确保以上模型均为 API 正式调用且保真,无提示词干扰(Agent 应用内置提示词除外)。
| 模型 | DeepSeek v4 Pro GA | Kimi k3 Max |
|---|
| 备注 | 首次报错,修改一次。使用了谷歌字体,能访问谷歌服务体验更好。 | 网页版,最高思考预算。 |
| 演示地址 | 点这里 | 点这里 |
实际效果只能说是高下立判。
三、 文笔与文本创作测试
国内模型:
海外模型(需特殊网络环境):
四、 总结
实话说,我觉得这次 DeepSeek v4 Pro 系列已经泯然众人矣了。
从当年 R1 时代的遥遥领先,到现在连自己最擅长的中文文字创作能力都慢慢不再领先。DS v4 Pro GA 这次好像真的有点过于赶鸭子上架了。当然——也不排除是 api 紧急路由回预览版了,小南梁啊小南梁,你输得很彻底!
补充一下:DeepSeek 全系现已严肃涨价!
是的孩子们 我们 DeepSeek 严肃学习友商超恶心峰谷价策略,各位同志们下次得先掐表再用 DeepSeek 了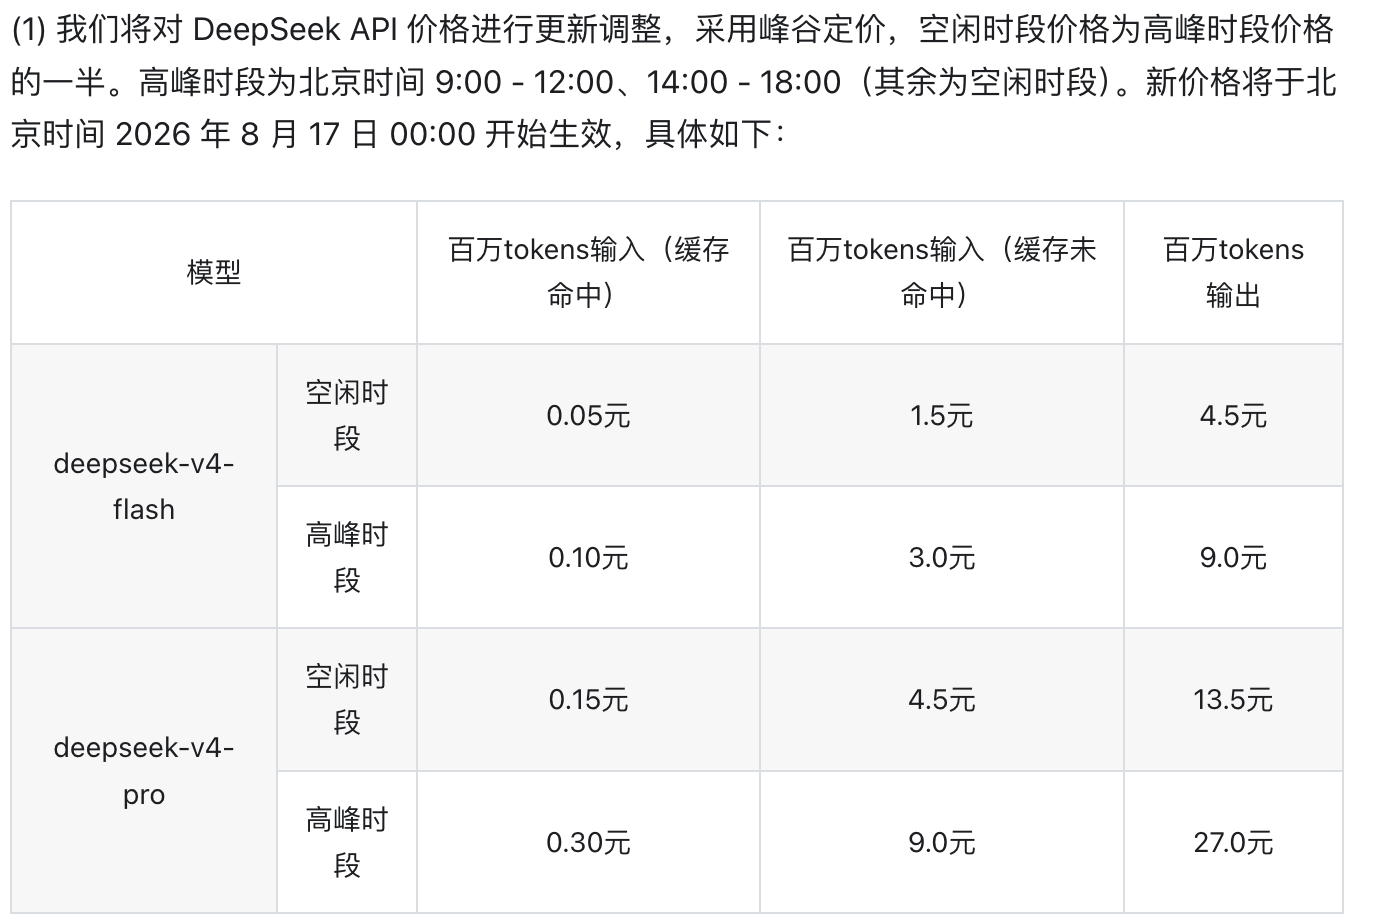
but!!!就在这时,DeepSeek Harness(简称 dsh) 发布!吓得奥特曼瘫坐在椅子上,仿佛看到宇宙爆炸!
官网
功能很多,界面不算复杂,有 webui